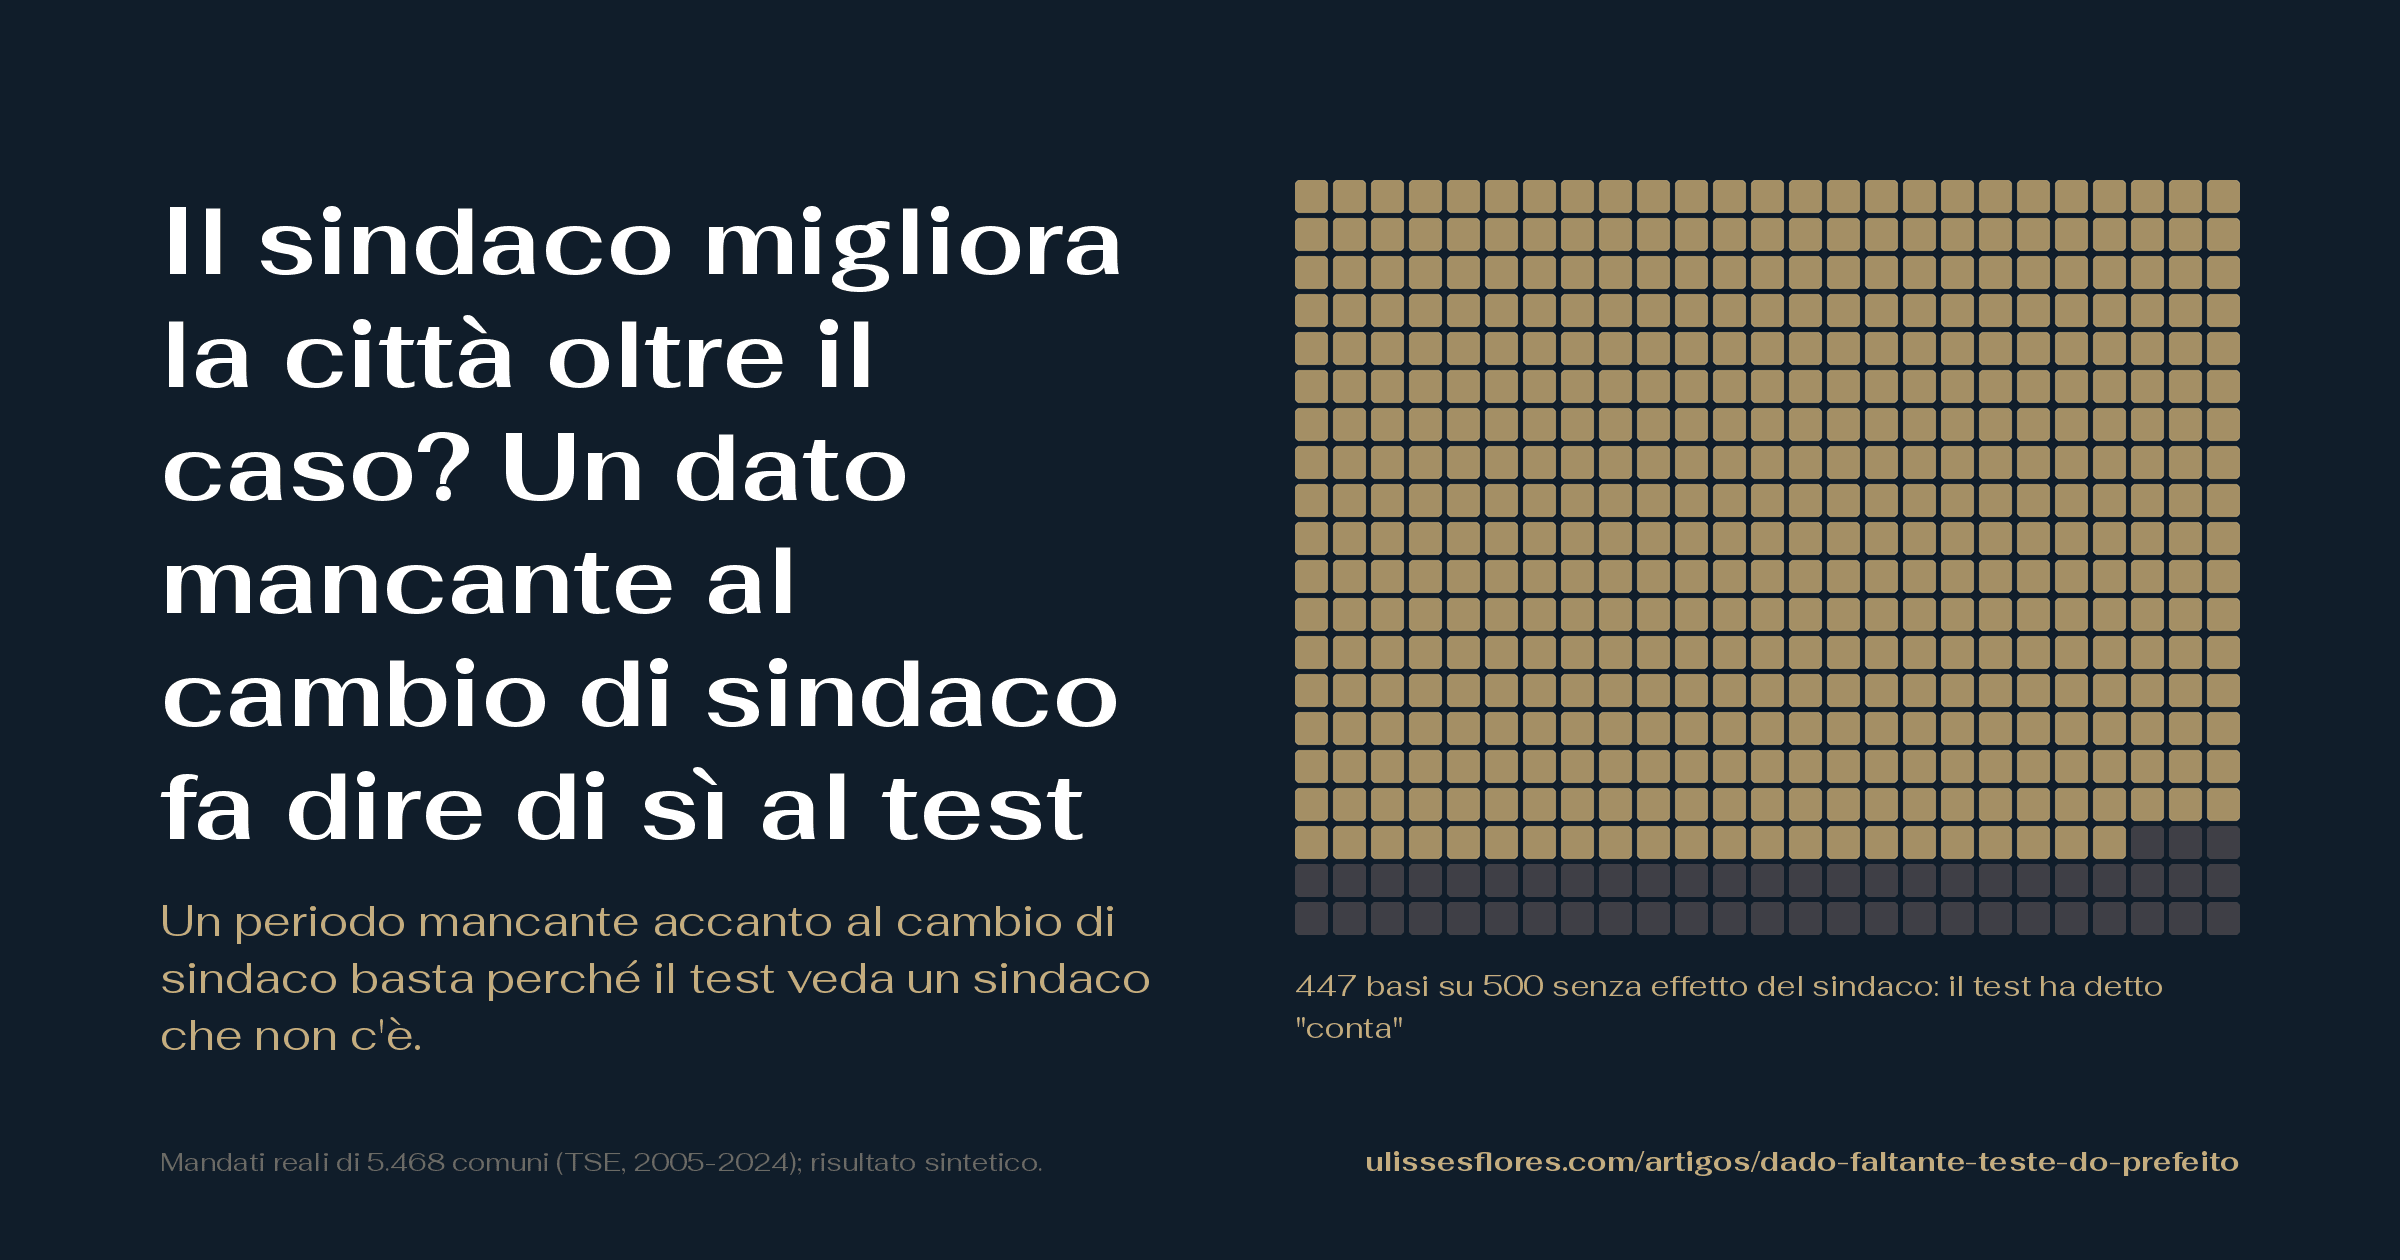
Il test che ho usato per capire se il sindaco brasiliano migliora la città ha detto di sì in città dove nessun sindaco faceva differenza. Il test è stato pubblicato su Science Advances nel 2021, da Christopher Berry e Anthony Fowler. L'ho applicato a un indice di punteggio scolastico, entrate proprie e mortalità infantile, dal 2005 al 2024. Prima di guardare i sindaci veri, ho fatto girare il test su dati inventati, in cui nessun sindaco faceva differenza. Nelle città con una lacuna nel mezzo della serie, ha detto "conta" nel 64,0% di 200 simulazioni. Un test onesto lo direbbe in circa il 5%. Lo studio si è fermato.
Con la lacuna solo all'inizio o alla fine della serie, lo stesso calcolo ha dato il 5,0%. Il margine rispettava i patti; il centro inventava il sindaco. Non è la prima volta che un mio studio si ferma a metà per colpa di ciò che spunta lungo la strada: è successo anche in il rifiuto che ha fermato lo studio dei rifiuti.
Non ho rianalizzato nessun risultato pubblicato di Berry e Fowler e non dico che qualcuno sia sbagliato. La correzione, l'opzione nostitch ("senza cucitura"), esiste già nel loro pacchetto. Ciò che ho misurato è ciò che le loro simulazioni non mettono insieme: un periodo mancante, anni vicini simili tra loro e migliaia di comuni.
Strappare una pagina dal diario e incollare le vicine non trasforma due giorni lontani in giorni consecutivi
Incollare la pagina di prima a quella di dopo non restituisce il giorno mancato. Fa solo finta che i due lati fossero vicini.
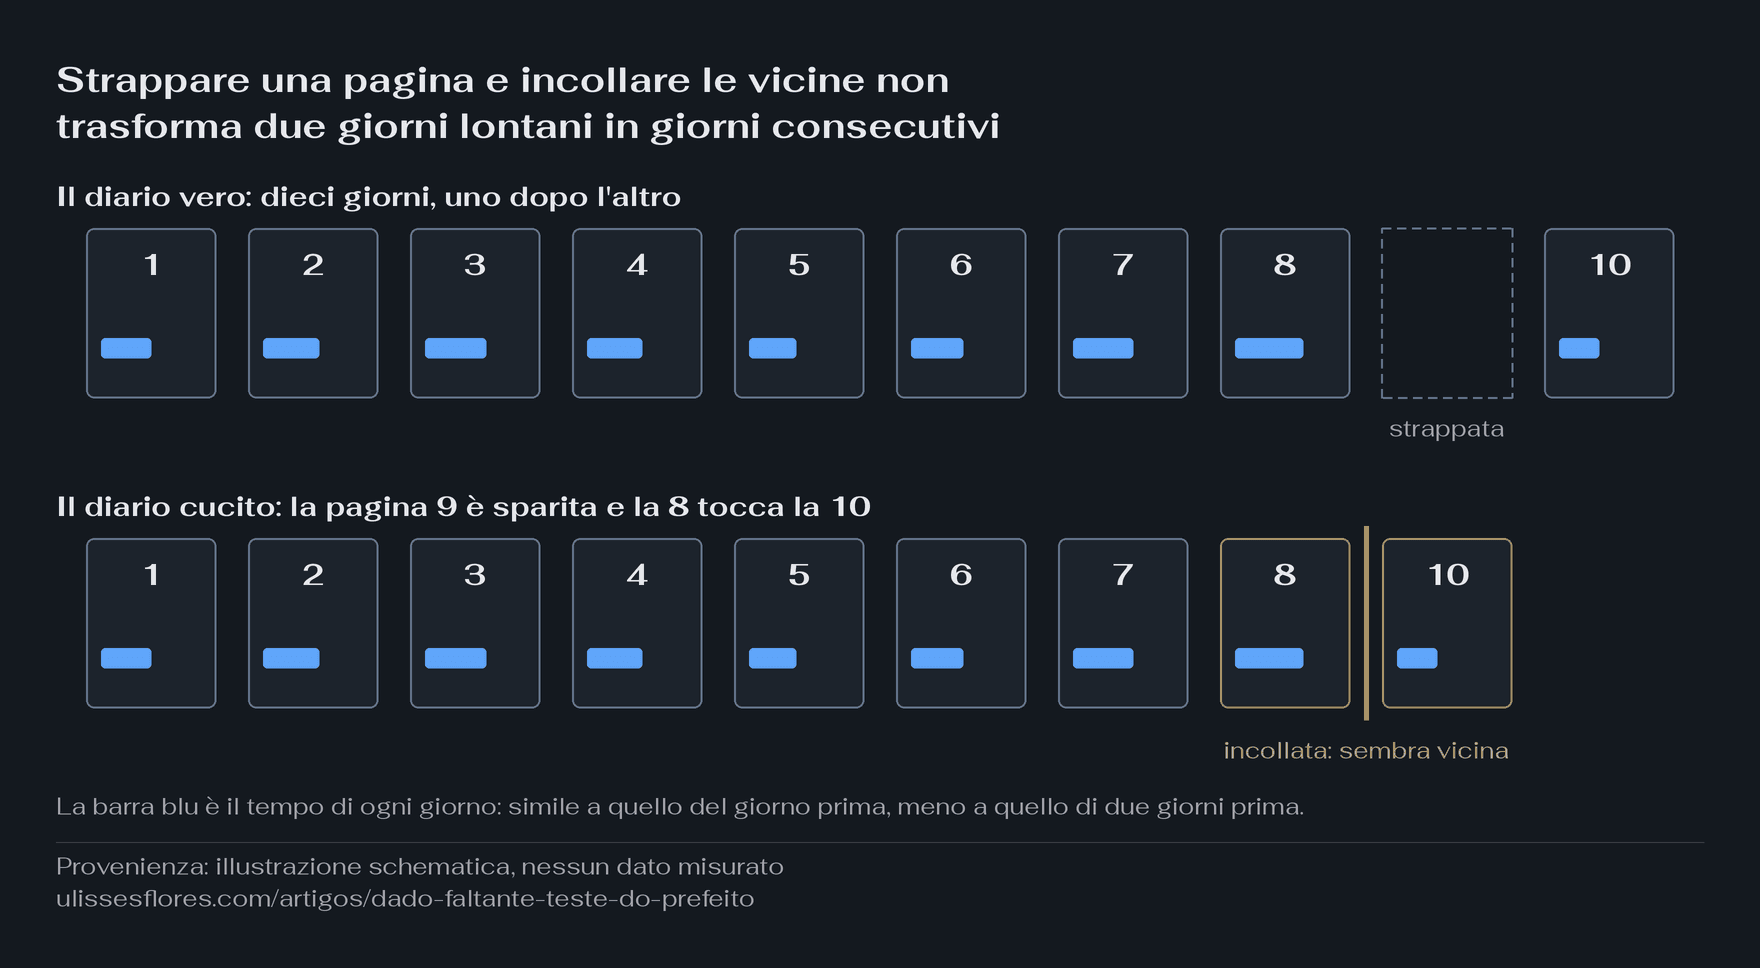
Notate le pagine 8 e 10 del diario in basso. Nel quaderno sono finite una accanto all'altra. Nel calendario sono a due giorni di distanza. Il tempo di un giorno somiglia a quello del giorno prima e un po' meno a quello di due giorni prima, e la colla nasconde questa differenza.
Nella città, ogni pagina è un mezzo mandato di due anni, e il "tempo" è l'indice della città. Punteggio scolastico, entrate e mortalità infantile si somigliano anch'essi da un biennio al successivo. Questa parentela tra periodi vicini si chiama correlazione seriale (serial correlation, "correlazione nel tempo"). Nelle simulazioni è modesta (coefficiente 0,217, calibrato sull'indice reale) e si indebolisce con la distanza.
Berry e Fowler trattano gli anni senza dato esattamente come la colla del diario. Con le parole dell'articolo: "we drop those observations and stitch together blocks of time" ("scartiamo quelle osservazioni e cuciamo insieme i blocchi di tempo"). Il pacchetto rifle, per il programma statistico Stata (catalogo SSC, codice S458461), fa la stessa cucitura per impostazione predefinita.
Il test rimescola l'ordine dei mandati e chiede se l'ordine reale spiega di più
Il test non misura se la città è migliorata. Misura se l'ordine vero dei sindaci spiega l'indice meglio degli ordini estratti.
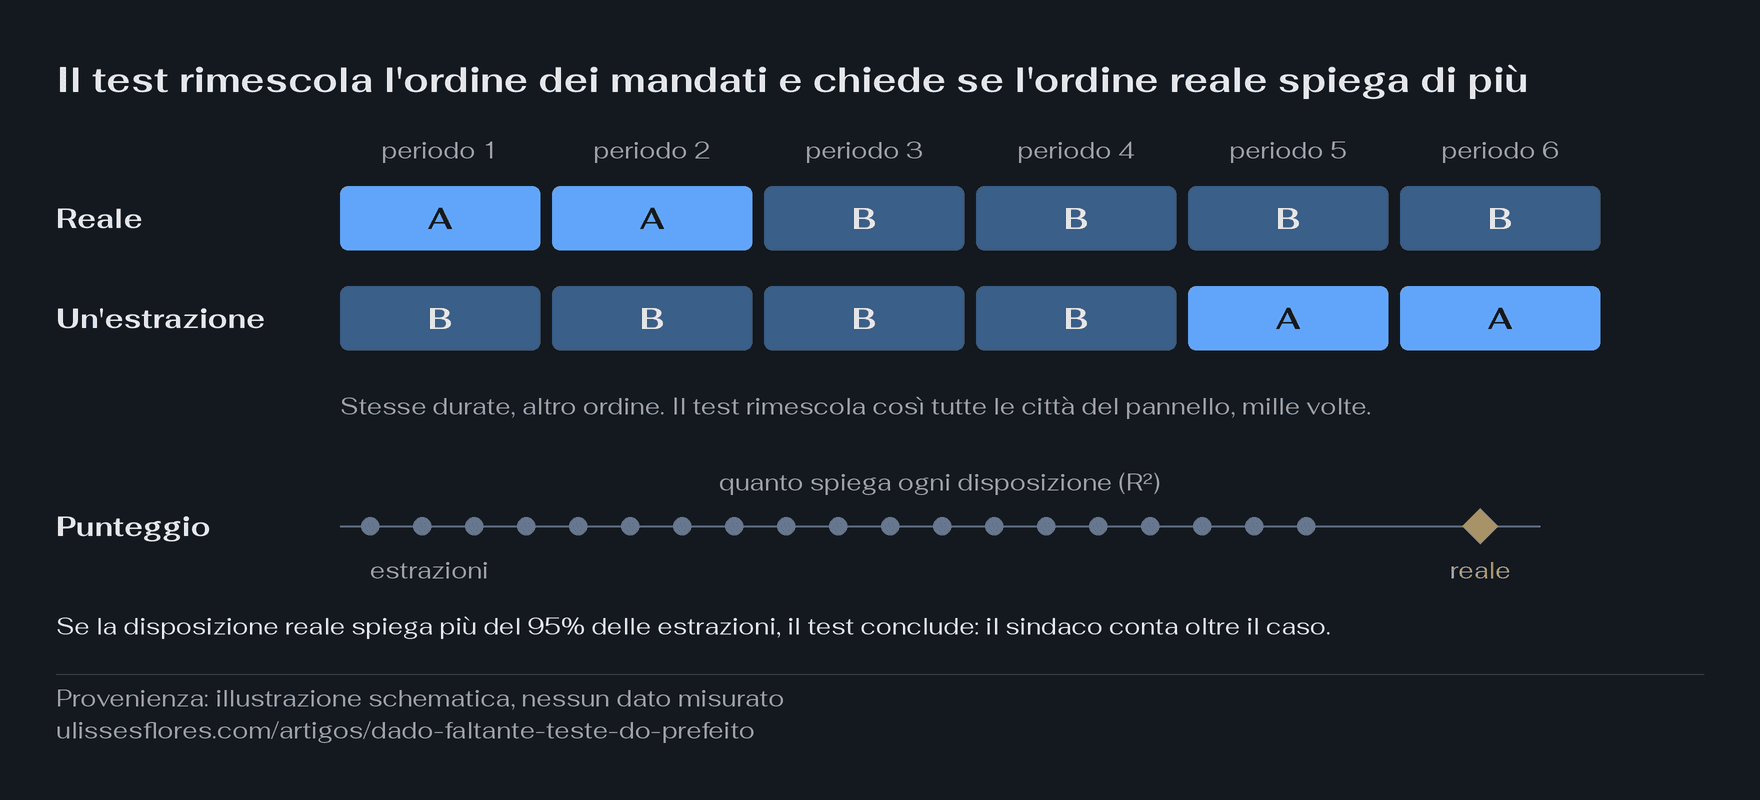
Notate che le due fasce hanno le stesse persone e le stesse durate; cambia solo l'ordine. Il nome del test è RIFLE, da Randomization Inference for Leader Effects ("inferenza per randomizzazione sugli effetti del leader").
Il calcolo, senza formule: copro il nome del sindaco e provo a indovinare l'indice di ogni periodo. Poi scopro il nome. Se i periodi di ciascuna persona si somigliano tra loro, conoscere il nome aiuta a indovinare. La fetta di variazione che il nome spiega, da zero a uno, è l'R² (R-squared, "R al quadrato"). Il test calcola l'R² della storia reale, con tutte le città del pannello insieme, e lo confronta con l'R² di mille estrazioni. In ogni estrazione, l'ordine dei mandati di ogni città viene rimescolato, ciò che si chiama permutazione (permutation, "riordinamento"). Se la storia reale batte quasi tutte le estrazioni, la conclusione è che il leader conta oltre il caso.
Ogni test sbaglia ogni tanto, e il patto è sbagliare poco. Un rilevatore di fumo può suonare per errore nel 5% delle notti; se suona nell'89% delle cucine senza fuoco, è difettoso. Questo tasso di falso allarme, misurato quando il sindaco non conta, si chiama size of the test ("dimensione del test"). Berry e Fowler hanno misurato questa dimensione in simulazioni senza lacuna nel mezzo della serie, come pannelli di 20 unità per 20 periodi, o senza correlazione seriale. Il difetto che ha fermato il mio studio sta proprio nella combinazione delle due cose.
Con la lacuna al cambio di sindaco, solo l'estrazione attraversa la lacuna
Quando la lacuna separa due sindaci, il mandato reale si ferma alla sua porta. Solo l'estrazione cucita unisce anni lontani nel calendario.
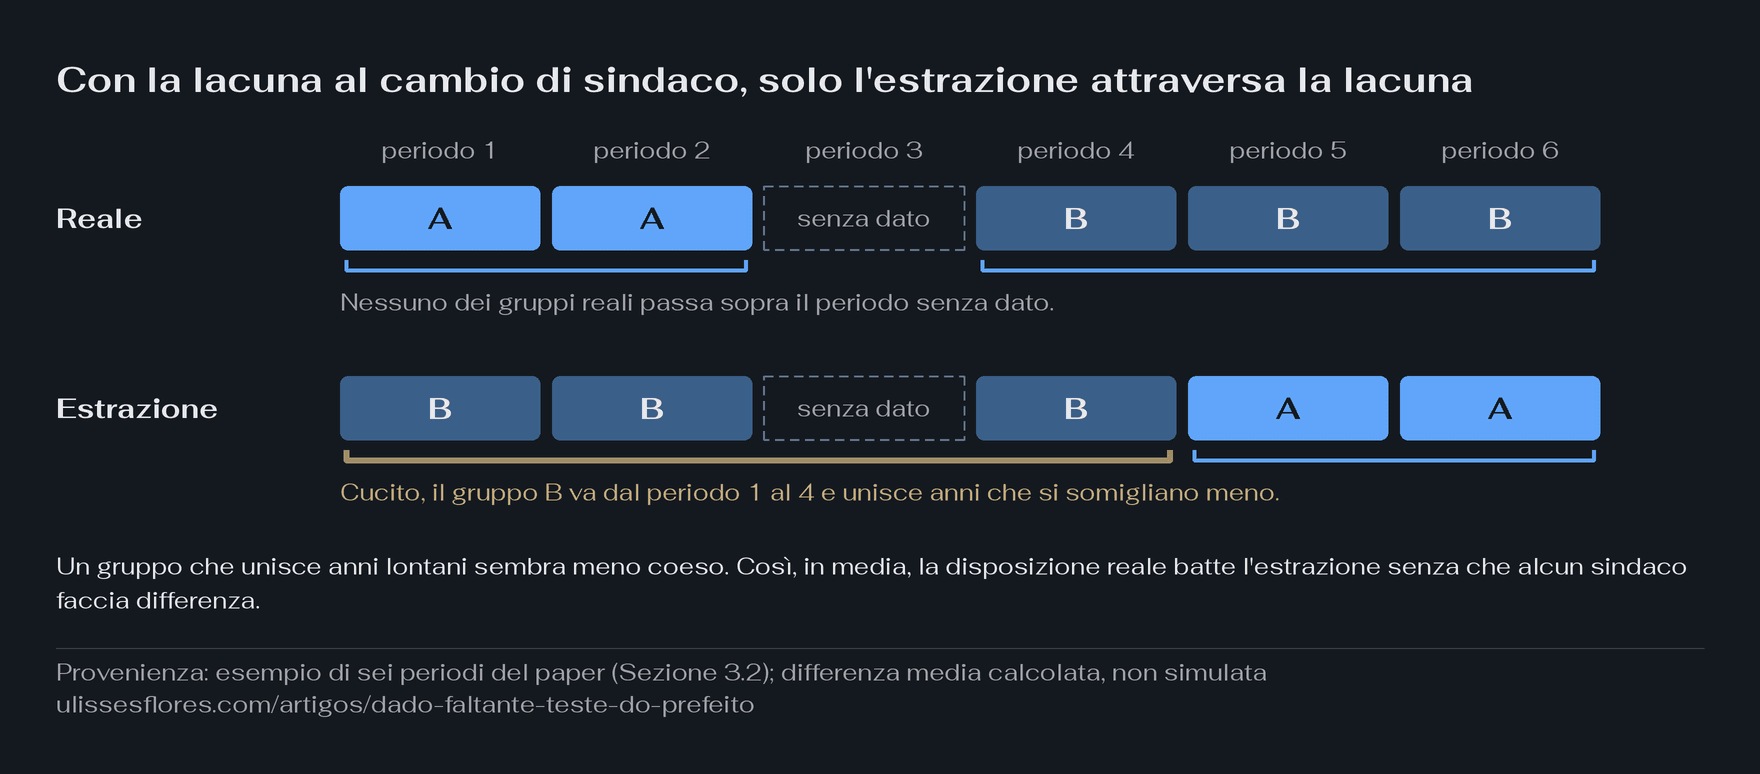
Notate la parentesi quadra dorata. Il sindaco A governa i periodi 1 e 2, B governa dal 3 al 6, e manca proprio il 3, quello del cambio. Nella storia reale, nessun mandato attraversa la lacuna. Nell'estrazione in cui B viene per primo, la cucitura mette il periodo 4 attaccato al 2, e il gruppo di B arriva a unire i periodi 1, 2 e 4.
I periodi 4 e 5 si somigliano, perché sono vicini davvero. I periodi 2 e 4 si somigliano meno, perché in mezzo c'è un intero biennio. La disposizione reale unisce solo vicini; quella estratta unisce periodi lontani, e per questo sembra meno coesa. In media, l'R² reale risulta maggiore di quello dell'estrazione, anche con l'indice generato senza alcun effetto di persona. L'allarme suona per colpa della colla, non del fuoco.
Senza la parentela tra anni vicini, la colla non inganna. In una simulazione con coefficiente zero, lacuna nel 2021-22 e 1.000 comuni, il test ha detto "conta" nel 6,4% delle basi, compatibile con il 5%.
La lacuna in un altro punto cambia il lato dell'errore
Il segno dipende da dove cade la lacuna. A metà di un mandato lungo, il test è diventato prudente: 0,2% con 867 comuni.
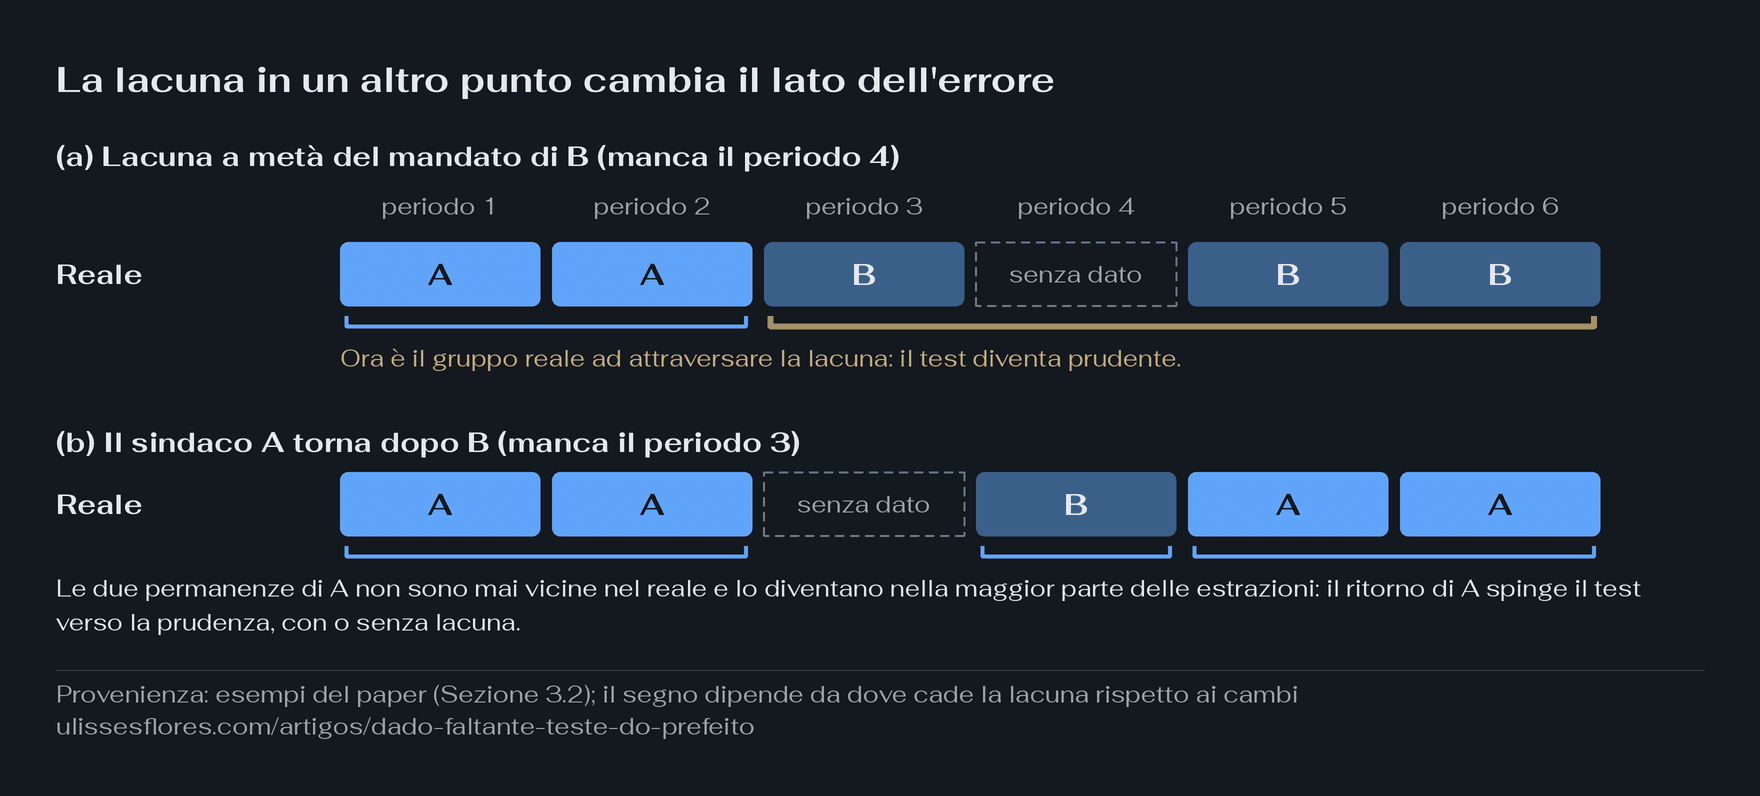
Notate che, nella scena (a), la parentesi quadra dorata ora è quella della disposizione reale. Con la lacuna a metà del mandato di B, è la storia vera a unire anni lontani, mentre l'estrazione resta con i vicini. Il test passa a sbagliare dal lato prudente: negli 867 comuni con la lacuna a metà di un mandato lungo, ha detto "conta" nello 0,2% delle basi, ben sotto il 5%.
Nella scena (b), il sindaco A esce e torna dopo B. Il pacchetto raggruppa i mandati per persona, e le due permanenze di A formano un gruppo solo, che nei dati reali non è mai contiguo. Nelle estrazioni, diventano vicine nella maggior parte degli ordini. A spingere il test dal lato prudente qui è il ritorno di A, e questo accade anche senza alcuna lacuna; la lacuna al cambio non fa che ridurre questa spinta, senza invertirla. Sono medie del calcolo esatto dell'articolo scientifico, non tassi di falso allarme simulati.
L'articolo scientifico riporta anche un esempio con la lacuna dentro un mandato in cui la disposizione reale torna a essere favorita. La regola che resta è semplice da dire e noiosa da applicare: il lato dell'errore dipende da dove cade la lacuna rispetto ai cambi di sindaco, e non solo dall'ampiezza della lacuna.
Poche città nascondono il difetto, e il pannello intero lo trasforma in quasi certezza
Con 50 comuni, il falso allarme resta al 6,8%, ancora compatibile con il 5%. Con 5.468, arriva all'89,4%.
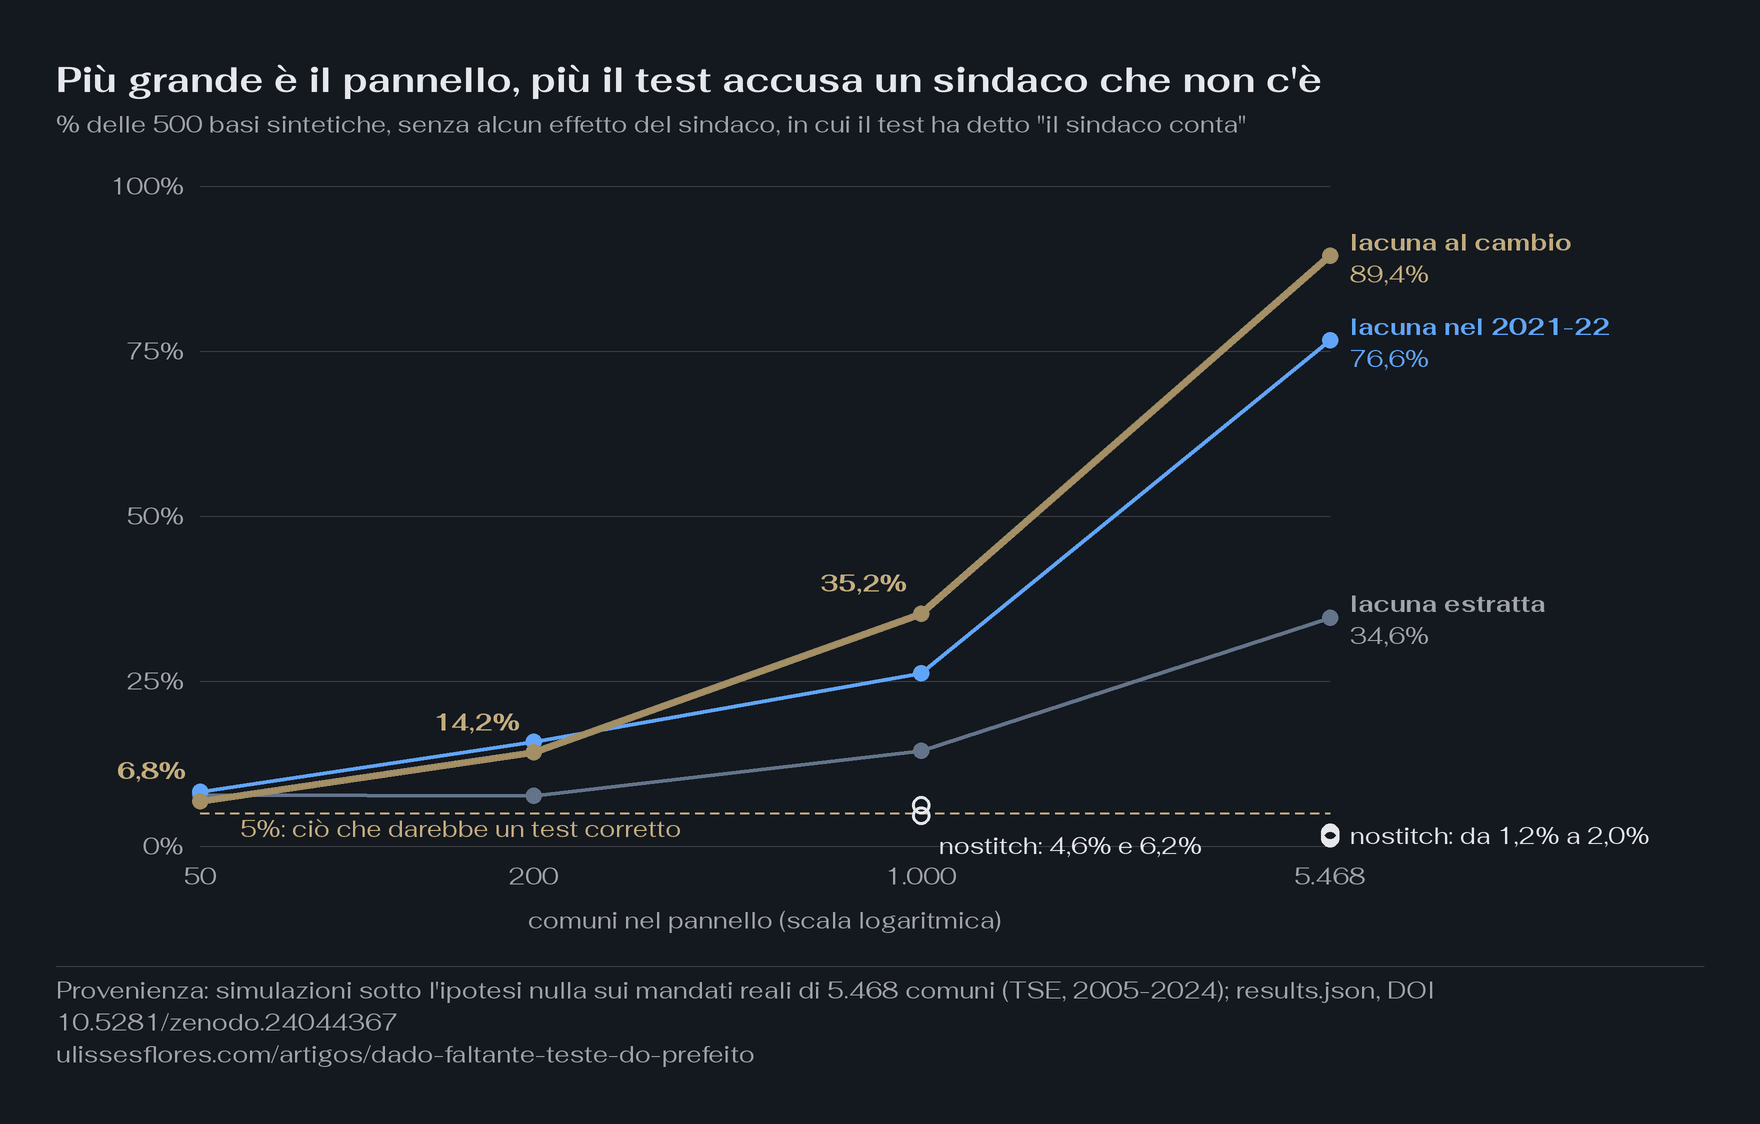
Notate l'inizio e la fine della linea dorata. Con 50 comuni e la lacuna al cambio, l'errore si distingue appena dal 5% che ogni test ha diritto di sbagliare, ed è per questo che passa inosservato nei pannelli piccoli. Con tutto il Brasile comunale, il test dice che il sindaco conta in quasi nove basi su dieci in cui nessun sindaco conta.
| Comuni | Lacuna al cambio | Lacuna nel 2021-22 | Lacuna estratta | Con nostitch |
|---|---|---|---|---|
| 50 | 6,8% | 8,2% | 7,8% | non misurato |
| 200 | 14,2% | 15,8% | 7,6% | non misurato |
| 1.000 | 35,2% | 26,2% | 14,4% | 4,6% (2021-22), 6,2% (estratta) |
| 5.468 | 89,4% | 76,6% | 34,6% | 1,2% (cambio), 1,6% (2021-22), 2,0% (estratta) |
Le tre colonne della cucitura sono tre posti per la lacuna. "Al cambio" è il caso puro: la lacuna separa sempre sindaci diversi. "2021-22" è il mezzo mandato subito dopo l'elezione, che nel 62,3% dei comuni separa sindaci diversi e, negli altri, ha la stessa persona da entrambi i lati; per questo, nei pannelli grandi, resta sotto il caso puro. "Estratta" è un periodo nel mezzo della serie, scelto a caso: ciò nonostante, il 70,1% di queste lacune cade accanto a un cambio, perché i mandati sono brevi, e il pannello intero arriva al 34,6%.
Con lo schema reale di dati mancanti dell'indice del mio studio, il risultato è lo stesso. Ho usato solo l'informazione su quali comuni hanno l'indice in ogni periodo e ho inventato il resto. Nei 1.854 comuni con lacuna nel mezzo della serie, la cucitura ha detto "conta" nel 34,8% delle basi, e nostitch nel 3,6%. Nei 707 con lacuna solo al margine, la cucitura ha dato il 3,8%. Il 64,0% che ha fermato lo studio veniva dal motore dello studio stesso; il pacchetto ufficiale, sulle stesse lacune, dà quel 34,8%. Entrambi sono lontani dal 5%.
Con nostitch, l'inflazione di decine di punti sparisce nelle celle misurate: con 1.000 comuni il test resta vicino al 5% (4,6% e 6,2%), e sul pannello intero diventa perfino prudente. Senza alcuna lacuna, il pacchetto è già sotto il 5% (2,2% con 1.000 comuni e 0,2% con i 5.468), e la causa non è stata isolata. Quando il sindaco conta davvero (effetto pari al 10% della variazione), il test lo rileva nel 98,8% delle basi senza lacuna e nel 98,4% con nostitch, entrambi con 1.000 comuni. La correzione, lì, non acceca il test. Questa rilevazione è stata misurata solo nelle celle in cui nostitch non scarta nessun tratto; con la lacuna al cambio, con 50 e 200 comuni e sul pannello intero, non l'ho misurata.
Con migliaia di diari, la stessa lacuna diventa un errore quasi certo
Un diario con una pagina incollata inganna poco. Migliaia, incollati nello stesso punto, ingannano quasi sempre: il test li somma tutti.
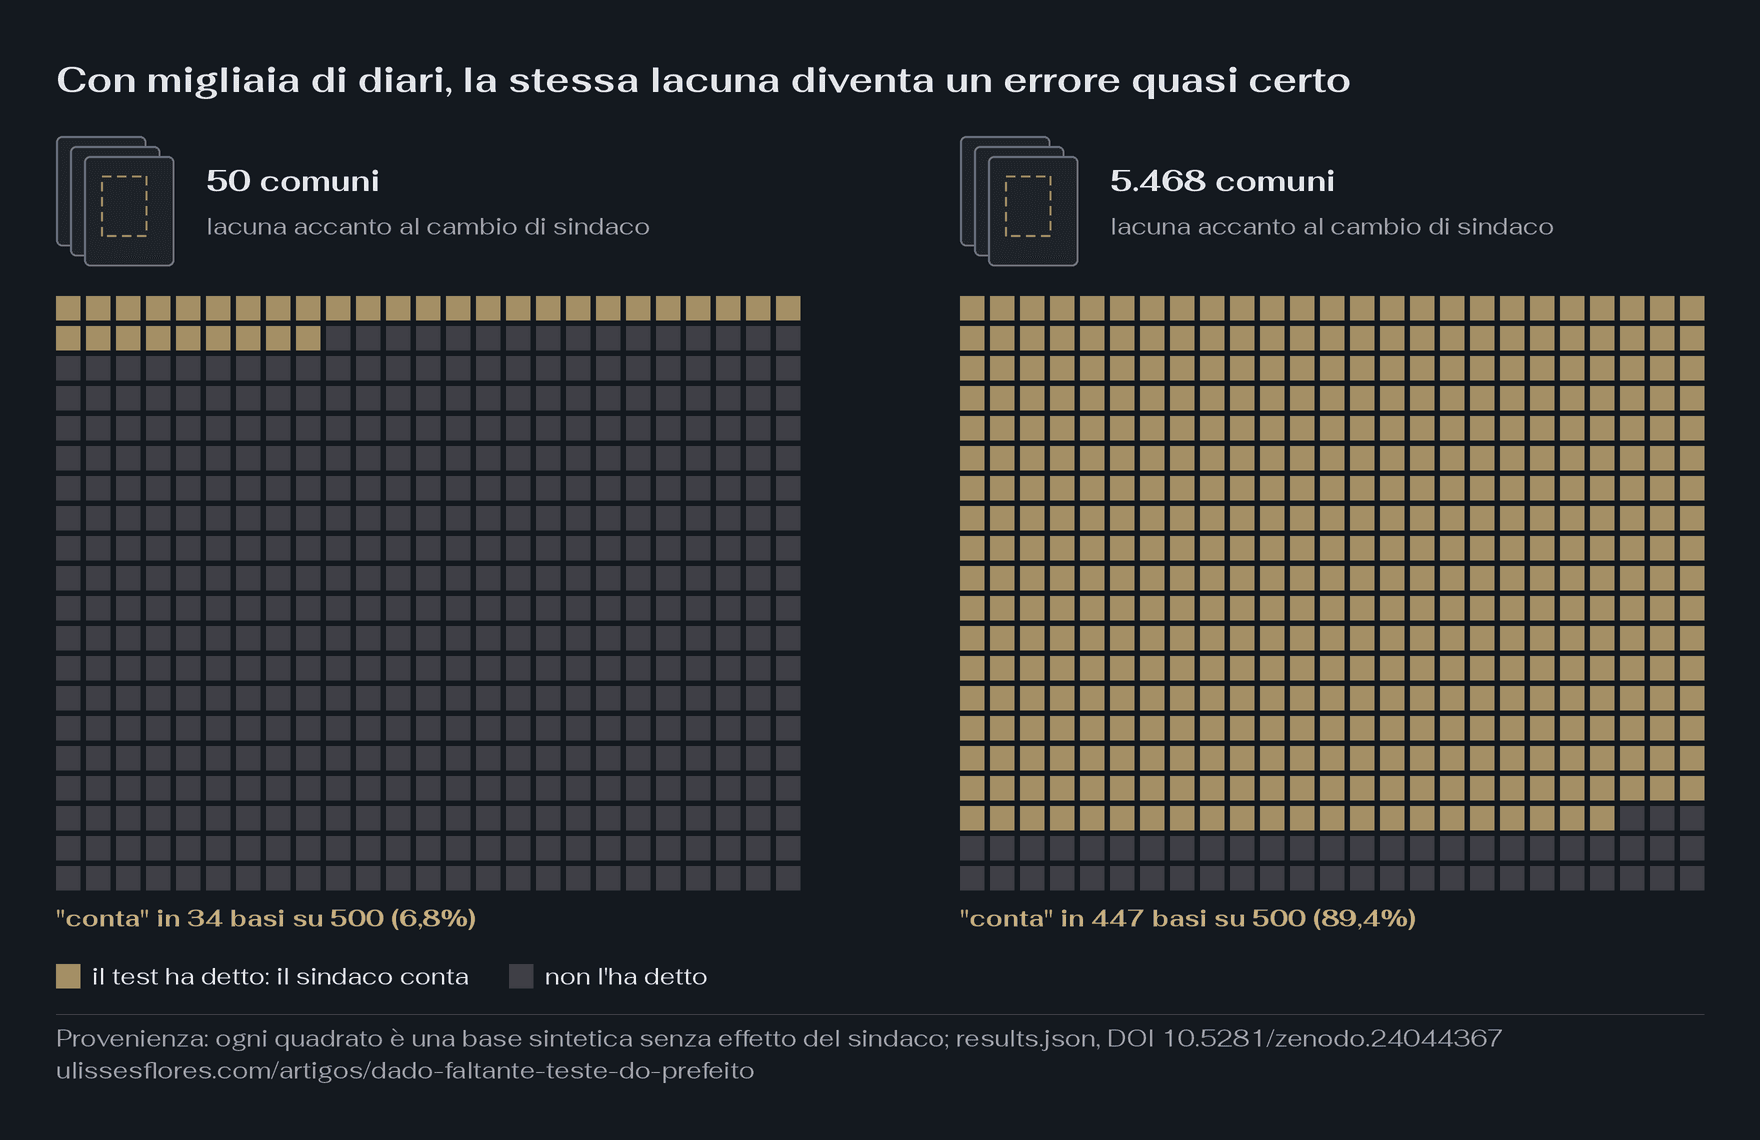
Notate che la pila di diari è quella della prima figura, ora con la pagina strappata sempre nello stesso punto rispetto al cambio di sindaco. Ogni comune spinge il risultato un pochino dallo stesso lato. Con 50, la spinta si perde nella normale variazione del test; con 5.468, le spinte si sommano e il test conclude quasi sempre che il sindaco conta. I pannelli piccoli e senza lacuna in cui la dimensione del test era stata verificata non avevano questa pila.
È quello che è successo nel mio studio. Ho rifatto il test estraendo l'ordine solo dentro tratti continui, un parente di nostitch, e ho confermato la dimensione al 5,2% in un ciclo di 2.000 basi dichiarato in anticipo. Solo allora ho guardato i sindaci veri, una volta sola. Non è comparsa evidenza di un effetto del sindaco: il valore p nel campione principale è stato 0,869, cioè la maggior parte delle estrazioni ha spiegato l'indice meglio della storia reale. La conclusione registrata è "equivalenza non dimostrata". I dati non mostrano un effetto del sindaco, e non permettono nemmeno di dire che il sindaco non conta.
Sapere se un governante conta è una domanda diversa dal sapere se una politica ha funzionato. La seconda ha i suoi metodi, e ciò che hanno già misurato in Brasile è in che cosa ha già misurato in modo causale la ricerca scientifica sulle politiche del Brasile. E quando la domanda è "quale governo è stato migliore", i dati pubblici rispondono solo in parte, come ho mostrato in che cosa rispondono i dati pubblici sul miglior governo del Brasile.
Che cosa farei con questo
Non scriverei che un leader conta senza aver prima misurato il falso allarme del test su dati in cui nessun leader conta.
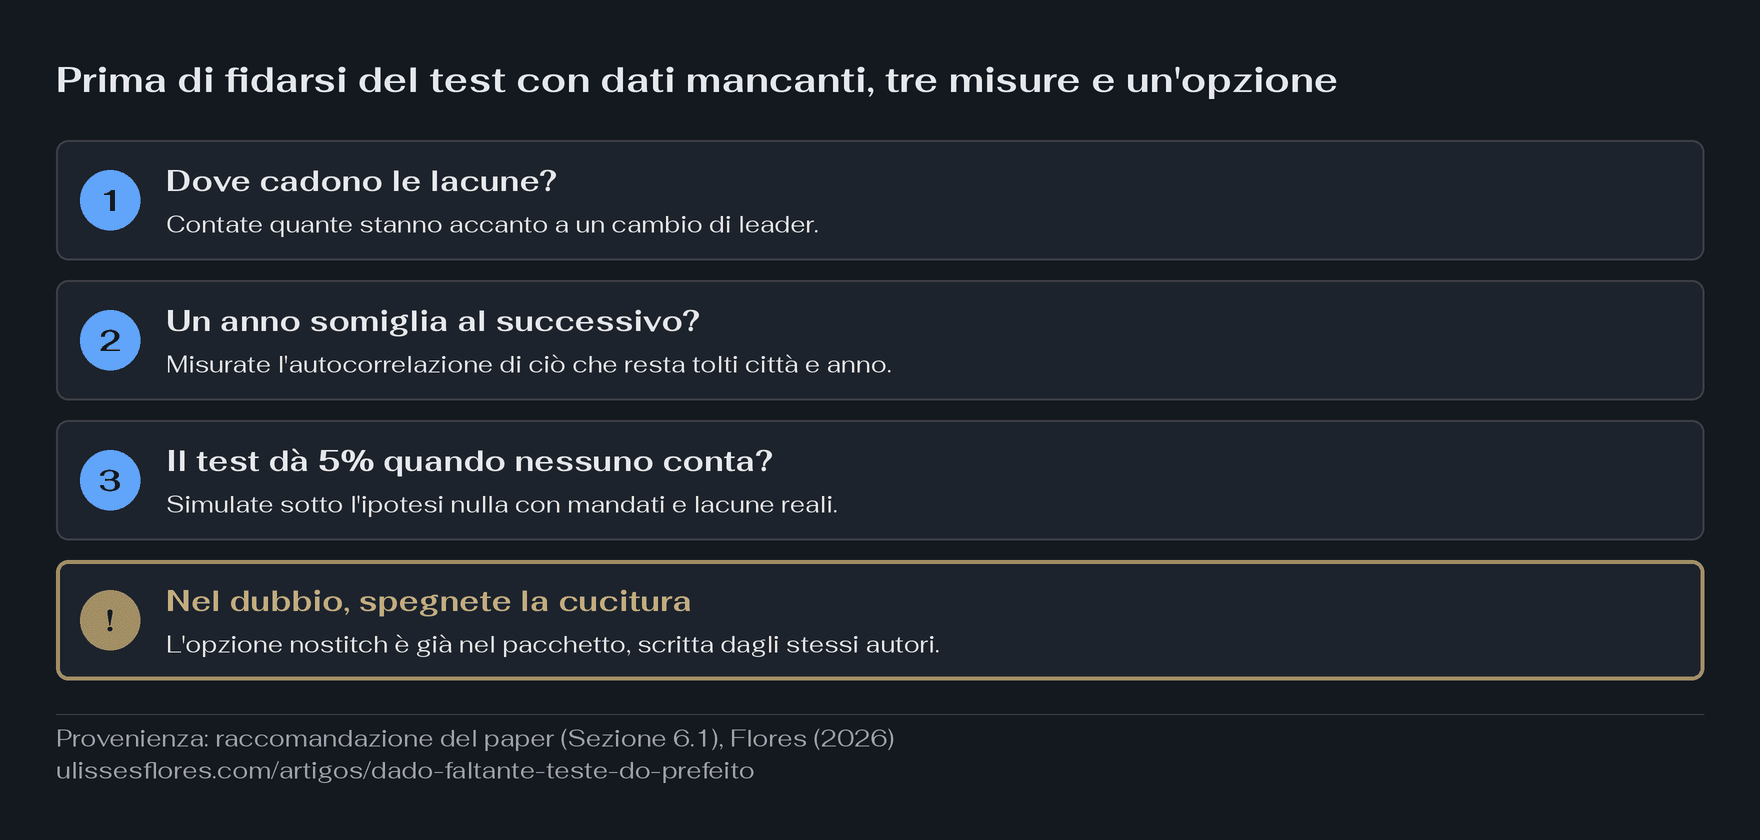
- Dove cadono le lacune? Contate quante stanno accanto a un cambio di leader. Qui, il 70,1% delle lacune estratte cade in quel punto.
- Un anno somiglia al successivo? Misurate l'autocorrelazione del residuo, ciò che resta del risultato dopo aver tolto la città e l'anno. Con 1.000 comuni e la lacuna nel 2021-22, la cucitura ha dato il 6,4% con coefficiente zero e il 26,2% con 0,217.
- Il test dà 5% quando nessuno conta? Simulate il test su dati senza effetto del leader, con i mandati reali e le lacune reali. Calibrare su un pannello piccolo e pubblicare su uno grande è calibrare un'altra domanda.
- Nel dubbio, spegnete la cucitura. La guida del pacchetto raccomanda già
nostitch"if there is a long gap between periods or some other reason not to comprate [sic] observations across missing periods" ("se c'è una lacuna lunga tra i periodi o un altro motivo per non confrontare le osservazioni attraverso i periodi mancanti"). Ciò che queste simulazioni aggiungono è che una lacuna breve, di un solo mezzo mandato, basta già quando cade al cambio: la lunghezza da sola non basta per la diagnosi, e la posizione della lacuna rispetto ai cambi deve entrarci.
nostitch non è una garanzia universale. Sul pannello intero ha reso il test prudente, tra l'1,2% e il 2,0%; con 1.000 comuni è rimasto vicino al 5% (4,6% e 6,2%, quest'ultimo senza escludere qualche punto di inflazione); in pannelli con un'altra struttura, non è stato misurato. E vale la pena ripeterlo: non ho rianalizzato nessun risultato pubblicato di Berry e Fowler, e la correzione è loro.
Quando l'articolo è uscito, nel 2021, la conversazione aperta su X e su Reddit ha riguardato chi conta di più, l'amministratore delegato di un'azienda o l'allenatore della squadra. In una ricerca del 7 novembre 2026, non ho trovato nessun post sui dati mancanti. Nelle basi accademiche che ho consultato (OpenAlex, Semantic Scholar, Crossref, la prima pagina di Google Scholar, oltre alla guida e al codice del pacchetto), non ho trovato nemmeno la distorsione documentata. Un lavoro che estende RIFLE, di Smith e Gray (2021), non l'ho letto per intero; se ha trattato di lacune, la parte del "nessuno l'aveva documentato" cade, e la misura fatta qui resta.
Dati e codice. Il codice, la traduzione del pacchetto in Python, gli output delle simulazioni e l'articolo scientifico completo in quattro lingue sono nel repository pubblico rifle-gap-bias, versione 1.0.0, citabile con il DOI di concetto 10.5281/zenodo.24044367. Nella cartella del repository, python run_all.py rifà le figure e la tabella e verifica ogni numero dell'articolo scientifico. Se il vostro calcolo viene diverso dalla tabella qui sopra, scrivetemi: correggo e vi do il credito.
Nota metodologica. Numeri verificati il 7 novembre 2026 rispetto al
results.jsondel repository, versione 1.0.0. Mandati reali del Tribunal Superior Eleitoral (il Tribunale Superiore Elettorale brasiliano): 5.468 comuni, dieci mezzi mandati di due anni, 2005-2024. Risultato sintetico: rumore autoregressivo con coefficiente 0,217, calibrato sull'indice reale, senza alcun effetto del sindaco nelle simulazioni di falso allarme. Ogni cella ha 500 basi e 1.000 estrazioni per base. Il 64,0% della fase pilota viene dal motore dello studio, non dalla traduzione del pacchetto. La traduzione del pacchetto in Python è stata testata a mano, non contro Stata, che non avevo.
Fonti
- Berry, C. R., & Fowler, A. (2021). Leadership or luck? Randomization inference for leader effects in politics, business, and sports ("Leadership o fortuna? Inferenza per randomizzazione sugli effetti del leader in politica, negli affari e nello sport"). Science Advances, 7(4), eabe3404. https://doi.org/10.1126/sciadv.abe3404
- Berry, C. R., & Fowler, A. (2018). RIFLE: Stata module to perform randomization inference for leader effects ("RIFLE: modulo Stata per eseguire l'inferenza per randomizzazione sugli effetti del leader"). Statistical Software Components S458461. https://ideas.repec.org/c/boc/bocode/s458461.html
- Flores, C. U. (2026). Does a mayor improve a city beyond chance? Missing data at a change of mayor makes the test say yes: Replication package ("Il sindaco migliora la città oltre il caso? Un dato mancante al cambio di sindaco fa dire di sì al test: pacchetto di replicazione", versione 1.0.0). Zenodo. https://doi.org/10.5281/zenodo.24044367. Repository: https://github.com/ulissesflores/rifle-gap-bias
- Smith, D. S., & Gray, T. R. (2021). Looking for leadership in historical context: An extension of the RIFLE method of randomization inference ("Cercare la leadership nel contesto storico: un'estensione del metodo RIFLE di inferenza per randomizzazione"). Journal of Historical Political Economy, 1(2), 215-234. https://doi.org/10.1561/115.00000010 (non letto per intero)
- Tribunal Superior Eleitoral. Portal de dados abertos (portale dei dati aperti). https://dadosabertos.tse.jus.br
Verificato il 7 novembre 2026 rispetto al results.json e all'articolo scientifico del repository rifle-gap-bias, versione 1.0.0. Non ho eseguito Stata: la traduzione del pacchetto in Python è stata testata a mano. Non ho rianalizzato nessun risultato pubblicato di Berry e Fowler. Non ho letto Smith e Gray (2021) per intero. La ricerca su X e su Reddit è stata fatta da un altro agente, e non ho aperto ogni post. I risultati delle simulazioni sono sintetici: la struttura dei mandati è reale, l'indice è stato inventato di proposito, senza effetto del sindaco.