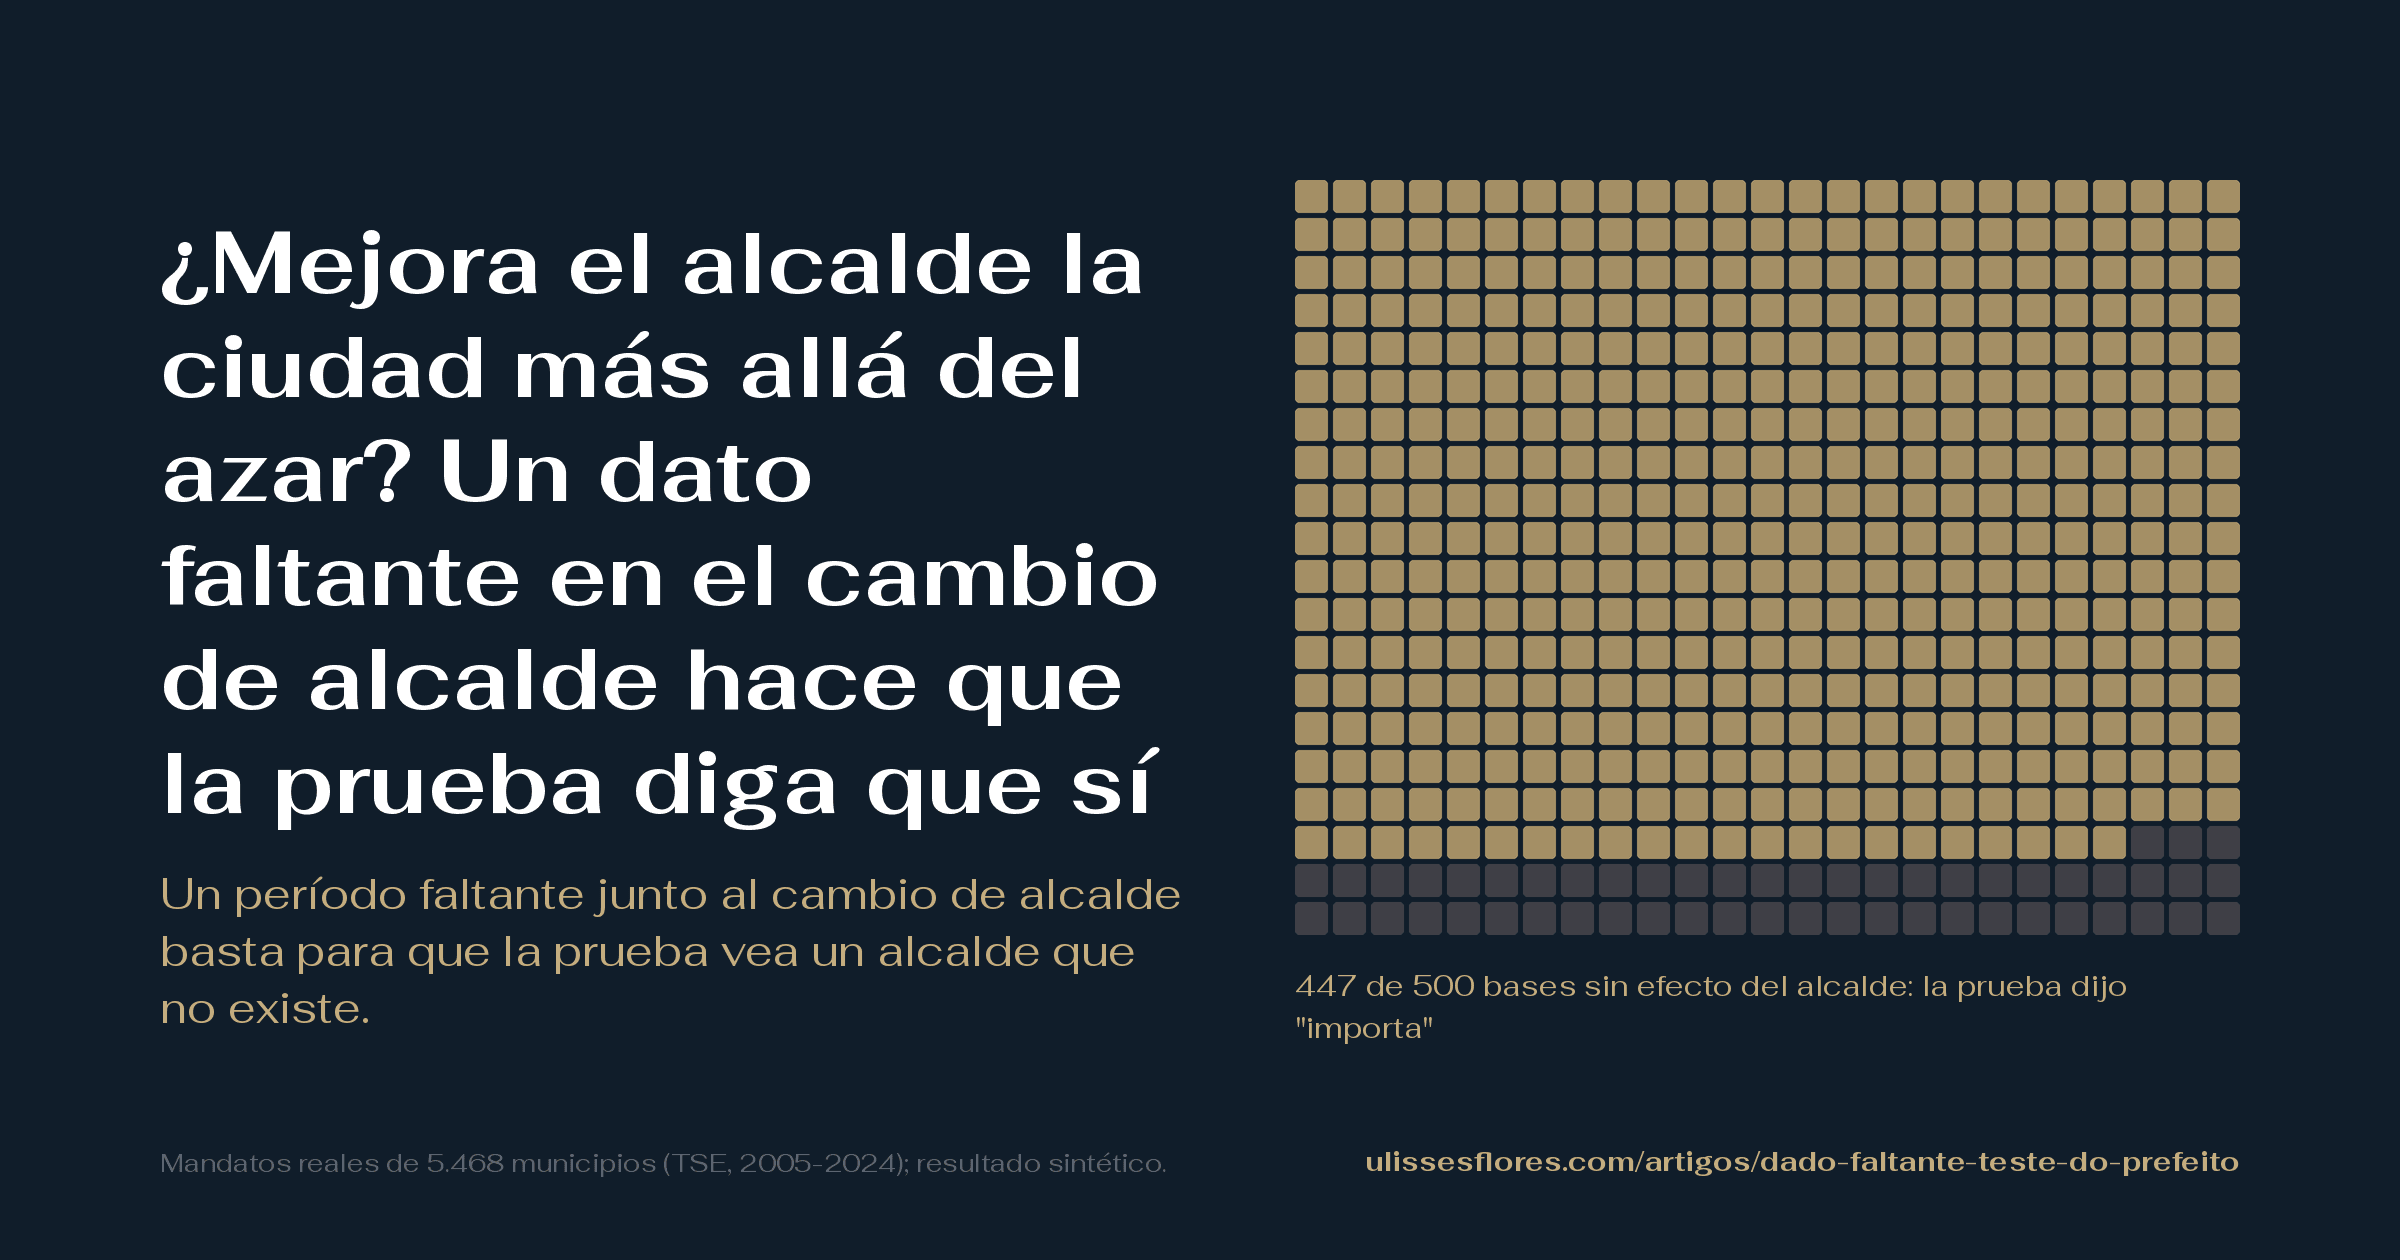
La prueba que usé para saber si el alcalde brasileño mejora la ciudad dijo que sí en ciudades donde ningún alcalde marcaba diferencia. Esa prueba la publicaron en Science Advances en 2021 Christopher Berry y Anthony Fowler. La apliqué a un índice de nota escolar, ingresos propios y mortalidad infantil, de 2005 a 2024. Antes de mirar a los alcaldes reales, corrí la prueba con datos inventados, sin ningún alcalde que marcara diferencia. En las ciudades con una laguna (un período sin dato) en medio de la serie, dijo "importa" en el 64,0% de 200 simulaciones. Una prueba honesta lo diría en torno al 5%. El estudio se detuvo.
Con la laguna solo al principio o al final de la serie, la misma cuenta dio 5,0%. El borde cumplía lo pactado; el medio inventaba alcaldes. No es la primera vez que un estudio mío se detiene a medias por lo que aparece en el camino: pasó también en el rechazo que detuvo el estudio de los rechazos.
No reanalicé ningún resultado publicado de Berry y Fowler y no digo que alguno esté equivocado. La corrección, la opción nostitch ("sin costura"), ya existe en su paquete. Lo que yo medí es lo que sus simulaciones no juntan: un período faltante, años vecinos parecidos entre sí y miles de municipios.
Arrancar una página del diario y pegar las vecinas no convierte dos días lejanos en días seguidos
Pegar la página de antes en la de después no devuelve el día que faltó. Solo finge que los dos lados fueron vecinos.
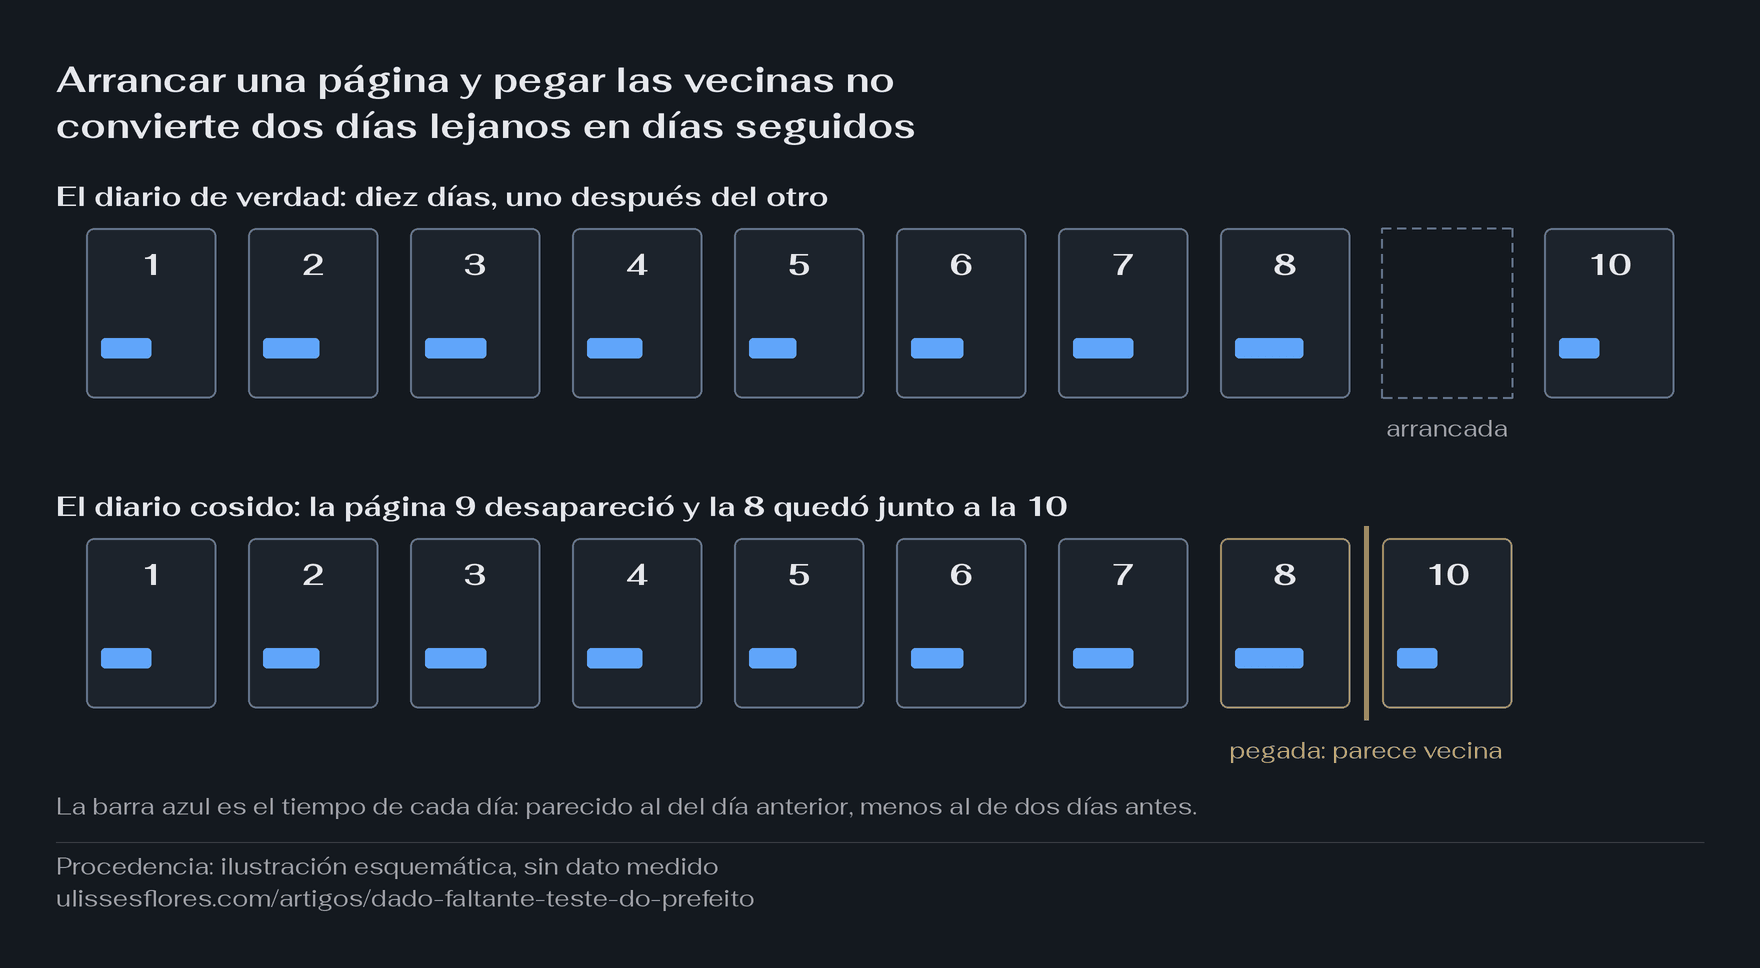
Fíjese en las páginas 8 y 10 de abajo. En el cuaderno quedaron lado a lado. En el calendario están a dos días de distancia. El tiempo de un día se parece al del día anterior y un poco menos al de dos días antes, y el pegamento esconde esa diferencia.
En la ciudad, cada página es un medio mandato de dos años, y el "tiempo" es el índice de la ciudad. Nota escolar, ingresos y mortalidad infantil también se parecen de un bienio al siguiente. Ese parentesco entre períodos vecinos se llama correlación serial (serial correlation, "correlación a lo largo del tiempo"). En las simulaciones es modesto (coeficiente 0,217, calibrado en el índice real) y se debilita con la distancia.
Berry y Fowler tratan los años sin dato exactamente como el pegamento del diario. En palabras del artículo: "we drop those observations and stitch together blocks of time" ("descartamos esas observaciones y cosemos los bloques de tiempo"). El paquete rifle, para el programa estadístico Stata (catálogo SSC, código S458461), hace la misma costura por defecto.
La prueba baraja el orden de los mandatos y pregunta si el orden real explica más
La prueba no mide si la ciudad mejoró. Mide si el orden verdadero de los alcaldes explica el índice mejor que órdenes sorteados.
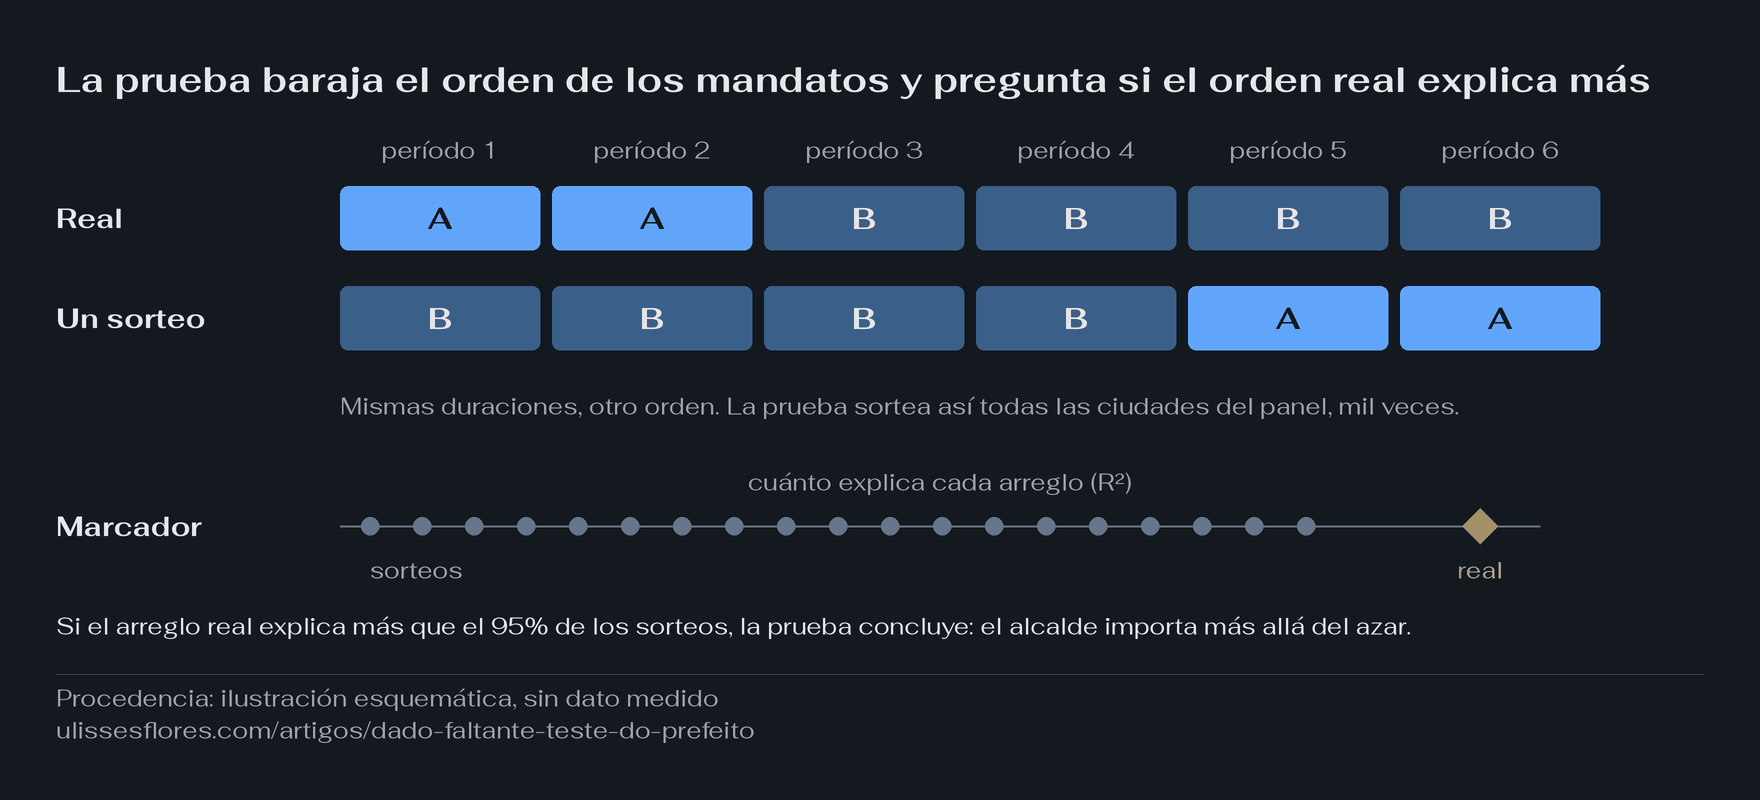
Fíjese en que las dos franjas tienen las mismas personas y las mismas duraciones; solo cambia el orden. El nombre de la prueba es RIFLE, de Randomization Inference for Leader Effects ("inferencia por aleatorización para efectos de líder").
La cuenta, sin fórmula: tapo el nombre del alcalde e intento adivinar el índice de cada período. Después descubro el nombre. Si los períodos de cada persona se parecen entre sí, saber el nombre ayuda a adivinar. La parte de la variación que explica el nombre, de cero a uno, es el R² (R-squared, "R al cuadrado"). La prueba calcula el R² de la historia real, con todas las ciudades del panel juntas, y lo compara con el R² de mil sorteos. En cada sorteo se baraja el orden de los mandatos de cada ciudad, lo que se llama permutación (permutation, "reordenación"). Si la historia real le gana a casi todos los sorteos, la conclusión es que el líder importa más allá del azar.
Toda prueba se equivoca de vez en cuando, y lo pactado es equivocarse poco. Un detector de humo puede pitar por error en el 5% de las noches; si pita en el 89% de las cocinas sin fuego, está defectuoso. Esa tasa de falsa alarma, medida cuando el alcalde no importa, se llama size of the test ("tamaño de la prueba"). Berry y Fowler midieron ese tamaño en simulaciones sin laguna en medio de la serie, como paneles de 20 unidades por 20 períodos, o sin correlación serial. El defecto que detuvo mi estudio vive justamente en la combinación de las dos cosas.
Con la laguna en el cambio de alcalde, solo el sorteo atraviesa la laguna
Cuando la laguna separa a dos alcaldes, el mandato real se detiene en su puerta. Solo el sorteo cosido junta años distantes en el calendario.
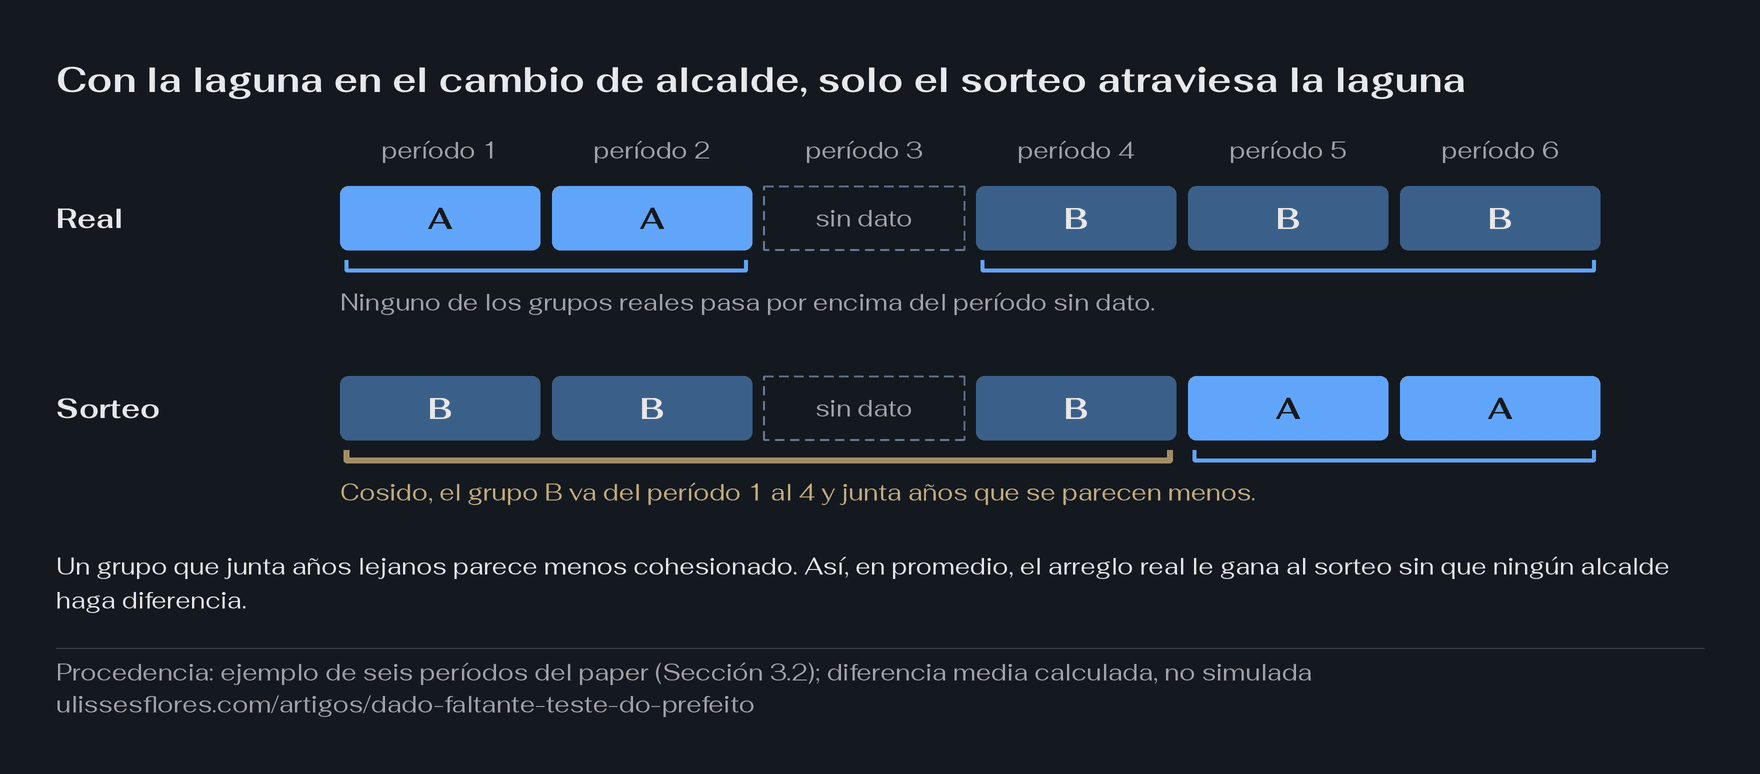
Fíjese en el corchete dorado. El alcalde A gobierna los períodos 1 y 2, B gobierna del 3 al 6, y falta justamente el 3, el del cambio. En la historia real, ningún mandato atraviesa la laguna. En el sorteo en que B va primero, la costura pone el período 4 pegado al 2, y el grupo de B pasa a juntar los períodos 1, 2 y 4.
Los períodos 4 y 5 se parecen, porque son vecinos de verdad. Los períodos 2 y 4 se parecen menos, porque hay un bienio entero entre ellos. El arreglo real solo junta vecinos; el sorteado junta períodos distantes, y por eso parece menos cohesionado. En promedio, el R² real queda mayor que el del sorteo, aun con el índice generado sin ningún efecto de persona. La alarma suena por el pegamento, no por el fuego.
Sin el parentesco entre años vecinos, el pegamento no engaña. En una simulación con coeficiente cero, laguna en 2021-22 y 1.000 municipios, la prueba dijo "importa" en el 6,4% de las bases, compatible con el 5%.
La laguna en otro lugar cambia el lado del error
El signo depende de dónde cae la laguna. En medio de un mandato largo, la prueba se volvió cautelosa: 0,2% en 867 municipios.
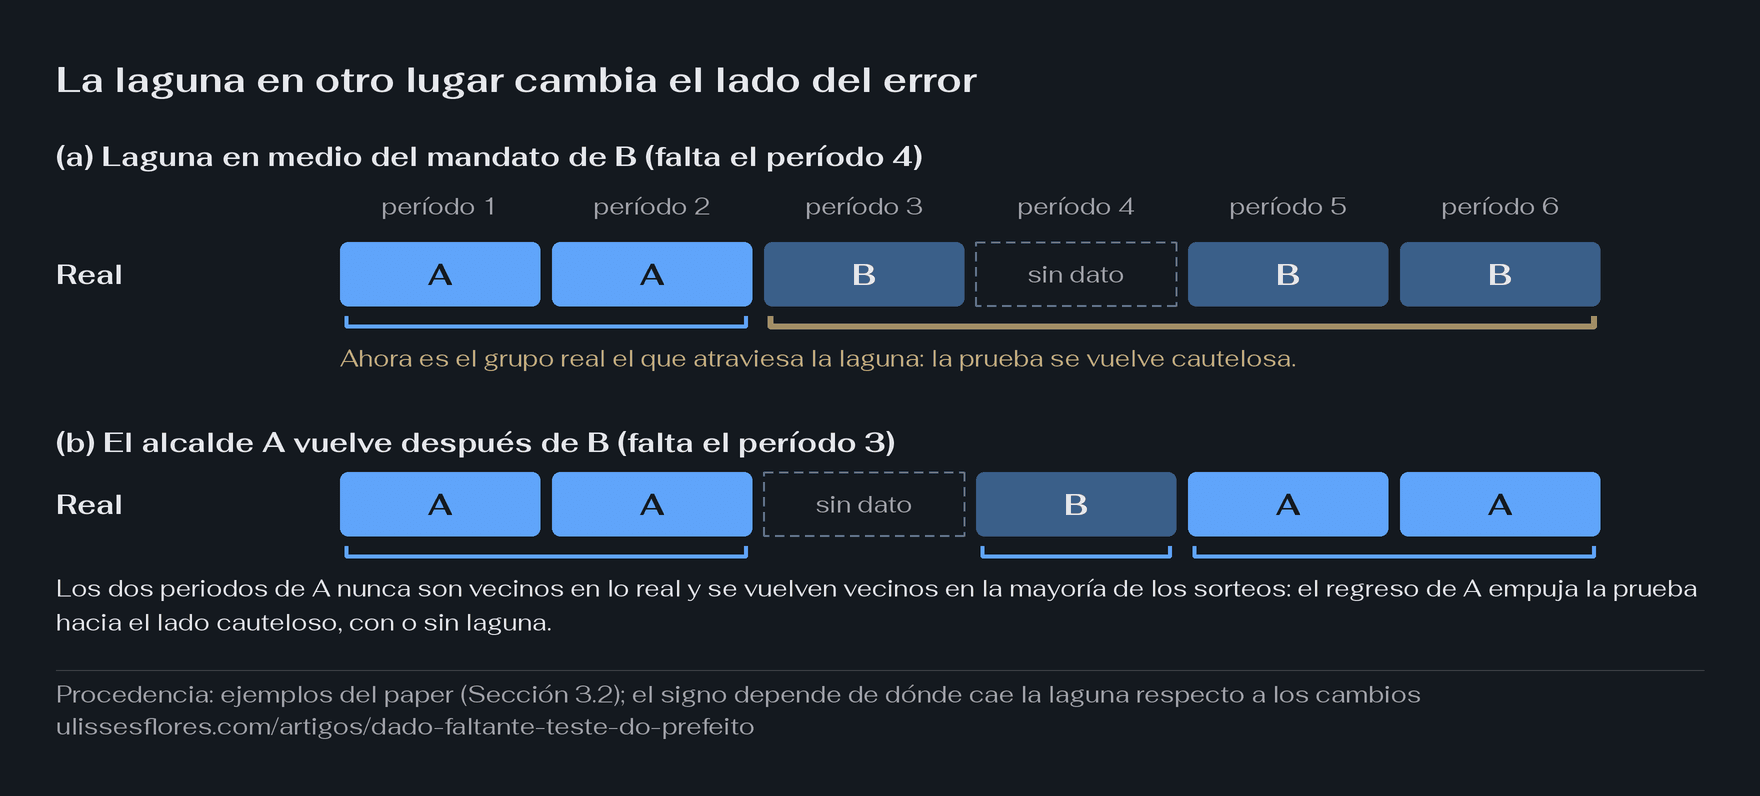
Fíjese en que, en la escena (a), el corchete dorado ahora es el del arreglo real. Con la laguna en medio del mandato de B, es la historia verdadera la que junta años distantes, y el sorteo es el que se queda con vecinos. La prueba pasa a errar hacia el lado cauteloso: en los 867 municipios con la laguna en medio de un mandato largo, dijo "importa" en el 0,2% de las bases, muy por debajo del 5%.
En la escena (b), el alcalde A sale y vuelve después de B. El paquete agrupa los mandatos por persona, y los dos pasos de A forman un solo grupo, que en los datos reales nunca queda pegado. En los sorteos, se vuelven vecinos en la mayoría de los órdenes. Quien empuja aquí la prueba hacia el lado cauteloso es el regreso de A, y eso ocurre incluso sin ninguna laguna; la laguna en el cambio solo reduce ese empujón, sin invertirlo. Son promedios de la cuenta exacta del paper, no tasas de falsa alarma simuladas.
El paper trae además un ejemplo con la laguna dentro de un mandato en que el arreglo real vuelve a salir favorecido. La regla que queda es simple de decir y pesada de aplicar: el lado del error depende de dónde cae la laguna en relación con los cambios de alcalde, y no solo del tamaño de la laguna.
Pocas ciudades esconden el defecto, y el panel entero lo convierte en casi certeza
Con 50 municipios, la falsa alarma queda en el 6,8%, aún compatible con el 5%. Con 5.468, llega al 89,4%.
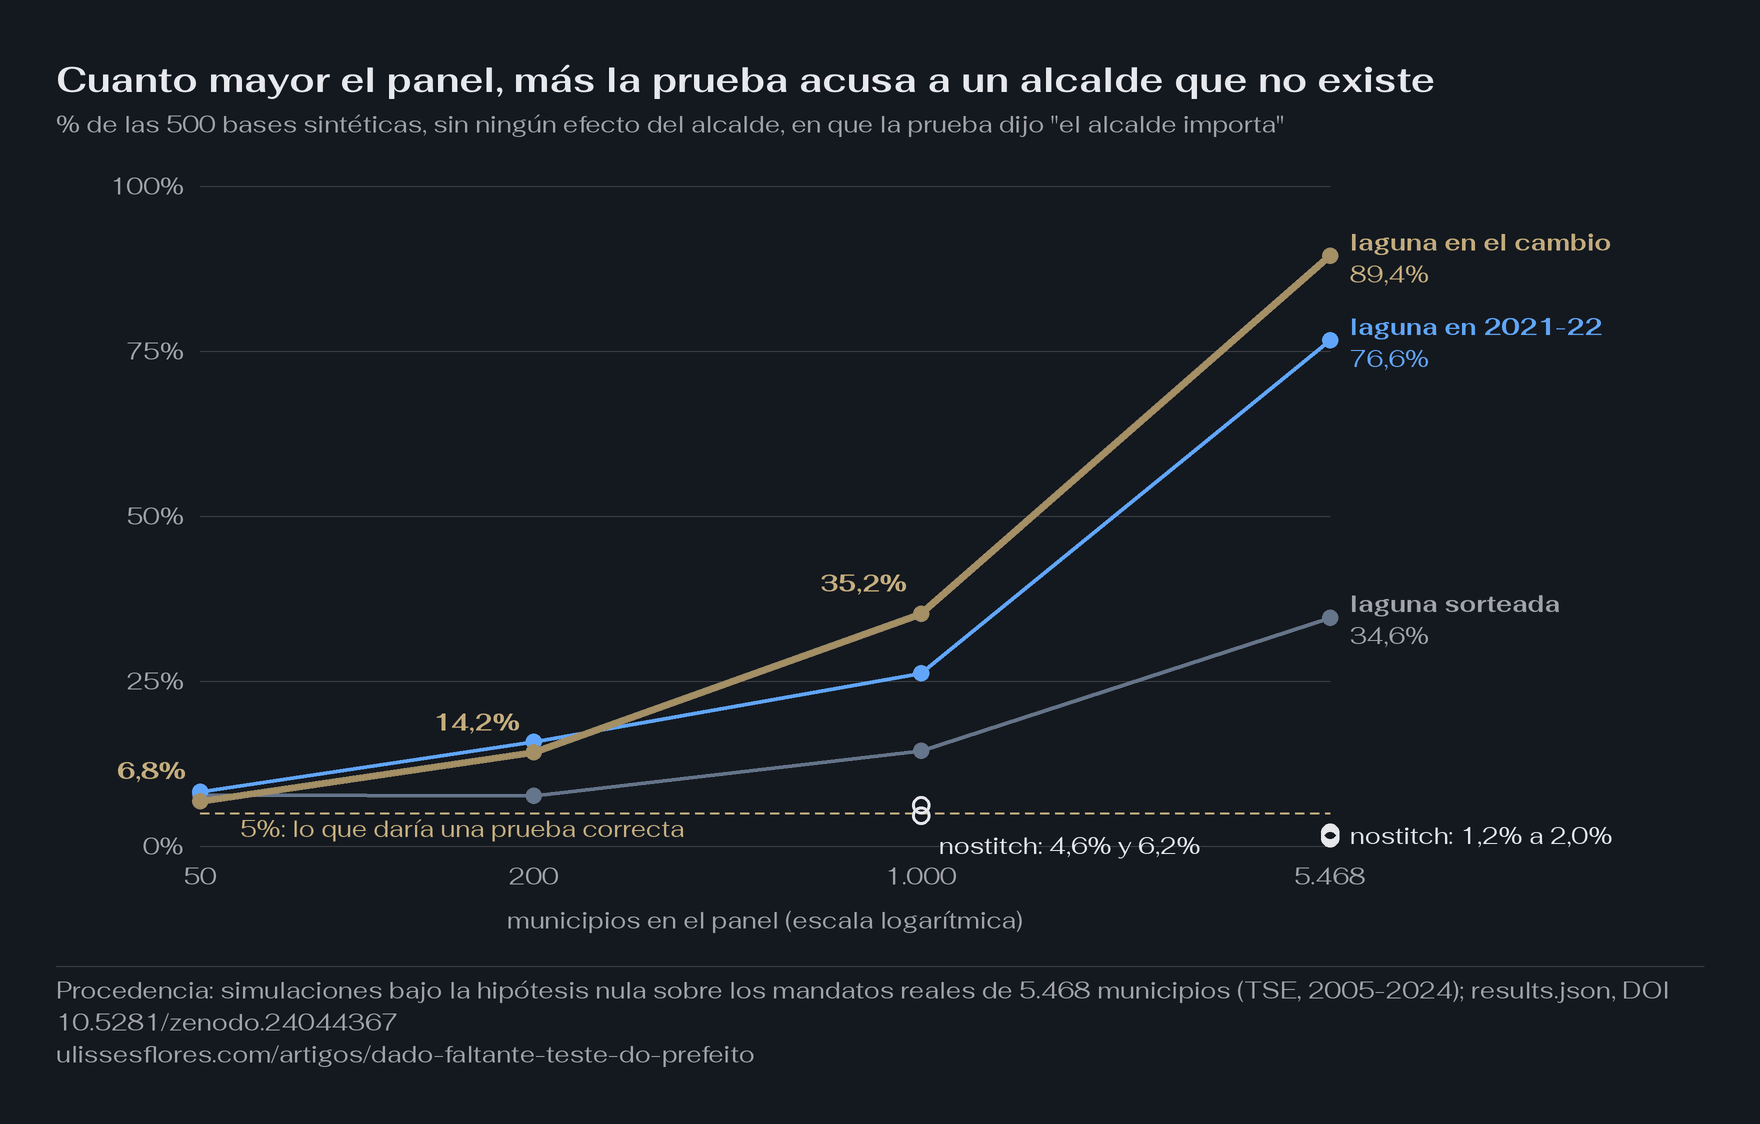
Fíjese en el principio y en el final de la línea dorada. Con 50 municipios y la laguna en el cambio, el error apenas se distingue del 5% que toda prueba tiene derecho a errar, y por eso pasa inadvertido en paneles pequeños. Con todo el Brasil municipal, la prueba dice que el alcalde importa en casi nueve de cada diez bases en que ningún alcalde importa.
| Municipios | Laguna en el cambio | Laguna en 2021-22 | Laguna sorteada | Con nostitch |
|---|---|---|---|---|
| 50 | 6,8% | 8,2% | 7,8% | no medido |
| 200 | 14,2% | 15,8% | 7,6% | no medido |
| 1.000 | 35,2% | 26,2% | 14,4% | 4,6% (2021-22), 6,2% (sorteada) |
| 5.468 | 89,4% | 76,6% | 34,6% | 1,2% (cambio), 1,6% (2021-22), 2,0% (sorteada) |
Las tres columnas de la costura son tres lugares para la laguna. "En el cambio" es el caso puro: la laguna siempre separa a alcaldes distintos. "2021-22" es el medio mandato inmediatamente posterior a la elección, que en el 62,3% de los municipios separa a alcaldes distintos y, en los demás, tiene a la misma persona a los dos lados; por eso, en los paneles grandes, queda por debajo del caso puro. "Sorteada" es un período del medio de la serie, elegido al azar: aun así, el 70,1% de esas lagunas cae junto a un cambio, porque los mandatos son cortos, y el panel entero llega al 34,6%.
Con el patrón real de datos faltantes del índice de mi estudio, el resultado es el mismo. Usé solo la información de qué municipios tienen el índice en cada período e inventé el resto. En los 1.854 municipios con laguna en medio de la serie, la costura dijo "importa" en el 34,8% de las bases, y nostitch en el 3,6%. En los 707 con laguna solo en el borde, la costura dio 3,8%. El 64,0% que detuvo el estudio vino del motor del propio estudio; el paquete oficial, en las mismas lagunas, da ese 34,8%. Los dos están lejos del 5%.
Con nostitch, la inflación de decenas de puntos desaparece en las celdas medidas: con 1.000 municipios la prueba queda cerca del 5% (4,6% y 6,2%), y en el panel entero queda incluso cautelosa. Sin ninguna laguna, el paquete ya queda por debajo del 5% (2,2% con 1.000 municipios y 0,2% con los 5.468), y la causa de eso no se aisló. Cuando el alcalde importa de verdad (efecto igual al 10% de la variación), la prueba detecta en el 98,8% de las bases sin laguna y en el 98,4% con nostitch, ambos con 1.000 municipios. La corrección, ahí, no ciega la prueba. Esa detección solo se midió en celdas en que nostitch no descarta ningún tramo; con la laguna en el cambio, con 50 y 200 municipios y en el panel entero, no medí.
Con miles de diarios, la misma laguna se vuelve un error casi seguro
Un diario con una página pegada engaña poco. Miles, pegados en el mismo lugar, engañan casi siempre, porque la prueba los suma a todos.
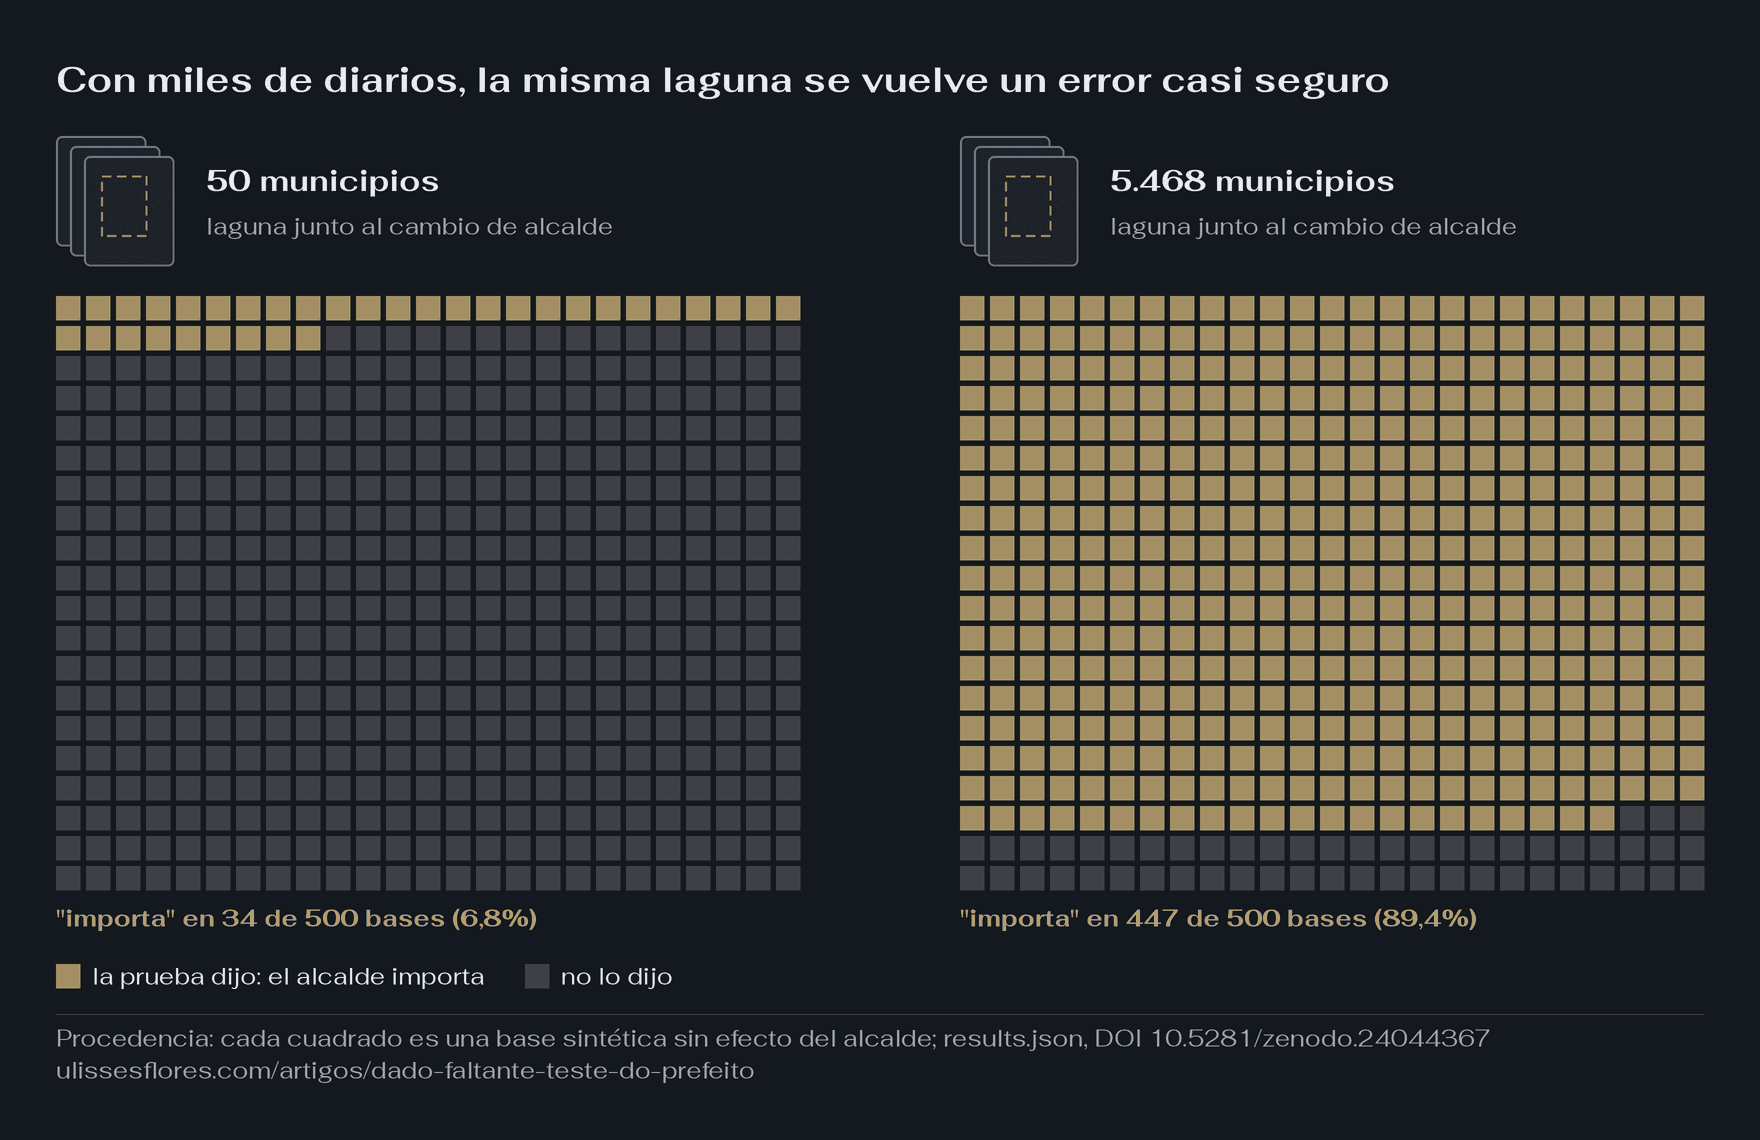
Fíjese en que la pila de diarios es la de la primera figura, ahora con la página arrancada siempre en el mismo lugar respecto al cambio de alcalde. Cada municipio empuja el resultado un poquito hacia el mismo lado. Con 50, el empujón se pierde en la variación normal de la prueba; con 5.468, los empujones se suman y la prueba casi siempre concluye que el alcalde importa. Los paneles pequeños y sin laguna en que se comprobó el tamaño de la prueba no tenían esta pila.
Eso fue lo que pasó en mi estudio. Rehíce la prueba sorteando el orden solo dentro de tramos continuos, pariente de nostitch, y confirmé el tamaño en 5,2% en una tanda de 2.000 bases declarada de antemano. Solo entonces miré a los alcaldes reales, una única vez. No apareció evidencia de efecto del alcalde: el valor p en la muestra principal fue 0,869, es decir, la mayoría de los sorteos explicó el índice mejor que la historia real. La conclusión registrada es "equivalencia no demostrada". Los datos no muestran efecto del alcalde, y tampoco permiten decir que el alcalde no importa.
Saber si un gobernante importa es una pregunta distinta de saber si una política funcionó. La segunda tiene sus propios métodos, y lo que ya han medido en Brasil está en lo que la investigación científica midió de forma causal sobre las políticas de Brasil. Y cuando la pregunta es "cuál gobierno fue mejor", los datos públicos responden solo una parte, como mostré en lo que responden los datos públicos sobre el mejor gobierno de Brasil.
Lo que yo haría con esto
Yo no escribiría que un líder importa sin antes medir la falsa alarma de la prueba con datos en que ningún líder importa.
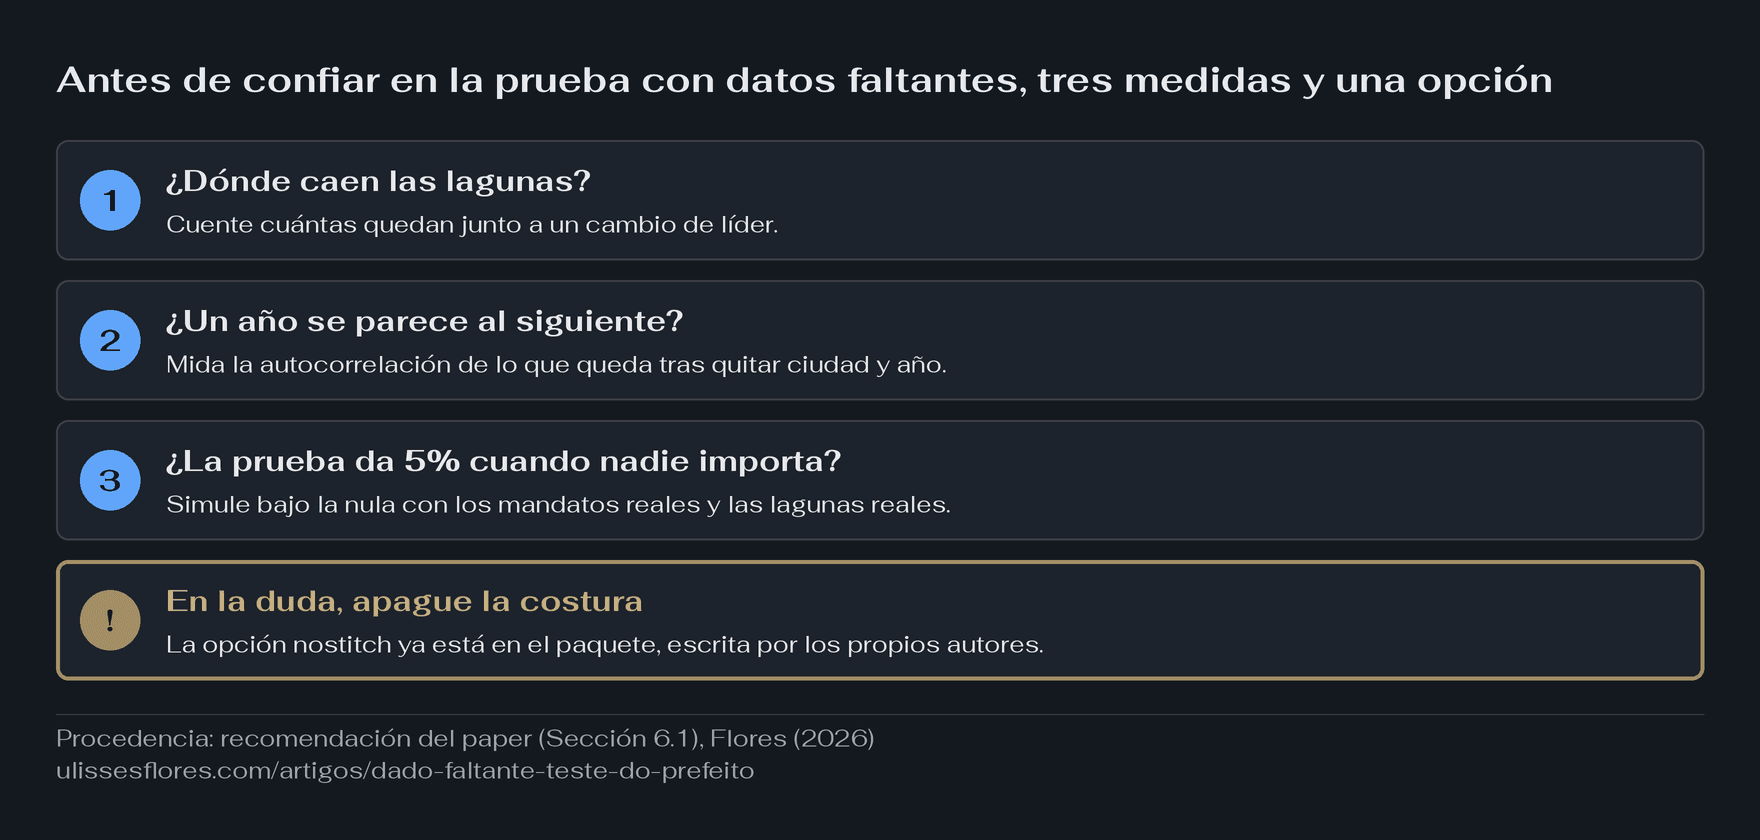
- ¿Dónde caen las lagunas? Cuente cuántas quedan junto a un cambio de líder. Aquí, el 70,1% de las lagunas sorteadas cae en ese lugar.
- ¿Un año se parece al siguiente? Mida la autocorrelación del residuo, lo que queda del resultado tras descontar la ciudad y el año. Con 1.000 municipios y la laguna en 2021-22, la costura dio 6,4% con coeficiente cero y 26,2% con 0,217.
- ¿La prueba da 5% cuando nadie importa? Simule la prueba con datos sin efecto de líder, con los mandatos reales y las lagunas reales. Calibrar en un panel pequeño y publicar en uno grande es calibrar otra pregunta.
- En la duda, apague la costura. La ayuda del paquete ya recomienda
nostitch"if there is a long gap between periods or some other reason not to comprate [sic] observations across missing periods" ("si hay una laguna larga entre períodos u otra razón para no comparar observaciones a través de los períodos faltantes"). Lo que estas simulaciones añaden es que una laguna corta, de un único medio mandato, ya basta cuando cae en el cambio: la longitud sola no basta para el diagnóstico, y la posición de la laguna en relación con los cambios tiene que entrar en él.
nostitch no es una garantía universal. En el panel entero dejó la prueba cautelosa, entre 1,2% y 2,0%; con 1.000 municipios quedó cerca del 5% (4,6% y 6,2%, este último sin excluir algunos puntos de inflación); en paneles con otra estructura, no se midió. Y conviene repetirlo: no reanalicé ningún resultado publicado de Berry y Fowler, y la corrección es suya.
Cuando salió el artículo, en 2021, la conversación abierta en X y en Reddit fue sobre quién importa más, si el presidente de una empresa o el entrenador del equipo. En una búsqueda el 7 de noviembre de 2026, no encontré ningún post sobre dato faltante. En las bases académicas que consulté (OpenAlex, Semantic Scholar, Crossref, la primera página de Google Scholar, además de la ayuda y el código del paquete), tampoco encontré la distorsión documentada. Un trabajo que extiende RIFLE, de Smith y Gray (2021), no lo leí íntegro; si trató de lagunas, la parte del "nadie lo había documentado" cae, y la medida hecha aquí continúa.
Datos y código. El código, la traducción del paquete a Python, las salidas de las simulaciones y el paper completo en cuatro idiomas están en el repositorio público rifle-gap-bias, versión 1.0.0, citable por el DOI de concepto 10.5281/zenodo.24044367. En la carpeta del repositorio, python run_all.py rehace las figuras y la tabla y comprueba cada número del paper. Si su cuenta da distinto de la tabla de arriba, mándeme su resultado: lo corrijo y le doy el crédito.
Nota metodológica. Números comprobados el 7 de noviembre de 2026 contra el
results.jsondel repositorio, versión 1.0.0. Mandatos reales del Tribunal Superior Electoral: 5.468 municipios, diez medios mandatos de dos años, 2005-2024. Resultado sintético: ruido autorregresivo con coeficiente 0,217, calibrado en el índice real, sin ningún efecto de alcalde en las simulaciones de falsa alarma. Cada celda tiene 500 bases y 1.000 sorteos por base. El 64,0% del piloto viene del motor del estudio, no de la traducción del paquete. La traducción del paquete a Python se probó a mano, no contra Stata, que yo no tenía.
Fuentes
- Berry, C. R., & Fowler, A. (2021). Leadership or luck? Randomization inference for leader effects in politics, business, and sports ("¿Liderazgo o suerte? Inferencia por aleatorización para efectos de líder en la política, los negocios y el deporte"). Science Advances, 7(4), eabe3404. https://doi.org/10.1126/sciadv.abe3404
- Berry, C. R., & Fowler, A. (2018). RIFLE: Stata module to perform randomization inference for leader effects ("RIFLE: módulo de Stata para realizar inferencia por aleatorización para efectos de líder"). Statistical Software Components S458461. https://ideas.repec.org/c/boc/bocode/s458461.html
- Flores, C. U. (2026). Does a mayor improve a city beyond chance? Missing data at a change of mayor makes the test say yes: Replication package ("¿Mejora un alcalde la ciudad más allá del azar? Un dato faltante en el cambio de alcalde hace que la prueba diga que sí: paquete de replicación") (versión 1.0.0). Zenodo. https://doi.org/10.5281/zenodo.24044367. Repositorio: https://github.com/ulissesflores/rifle-gap-bias
- Smith, D. S., & Gray, T. R. (2021). Looking for leadership in historical context: An extension of the RIFLE method of randomization inference ("En busca del liderazgo en el contexto histórico: una extensión del método RIFLE de inferencia por aleatorización"). Journal of Historical Political Economy, 1(2), 215-234. https://doi.org/10.1561/115.00000010 (no leído íntegro)
- Tribunal Superior Electoral. Portal de datos abiertos. https://dadosabertos.tse.jus.br
Verificado el 7 de noviembre de 2026 contra el results.json y el paper del repositorio rifle-gap-bias, versión 1.0.0. No corrí Stata: la traducción del paquete a Python se probó a mano. No reanalicé ningún resultado publicado de Berry y Fowler. No leí a Smith y Gray (2021) íntegro. La búsqueda en X y en Reddit la hizo otro agente, y no abrí cada post. Los resultados de las simulaciones son sintéticos: la estructura de los mandatos es real, el índice se inventó a propósito, sin efecto de alcalde.