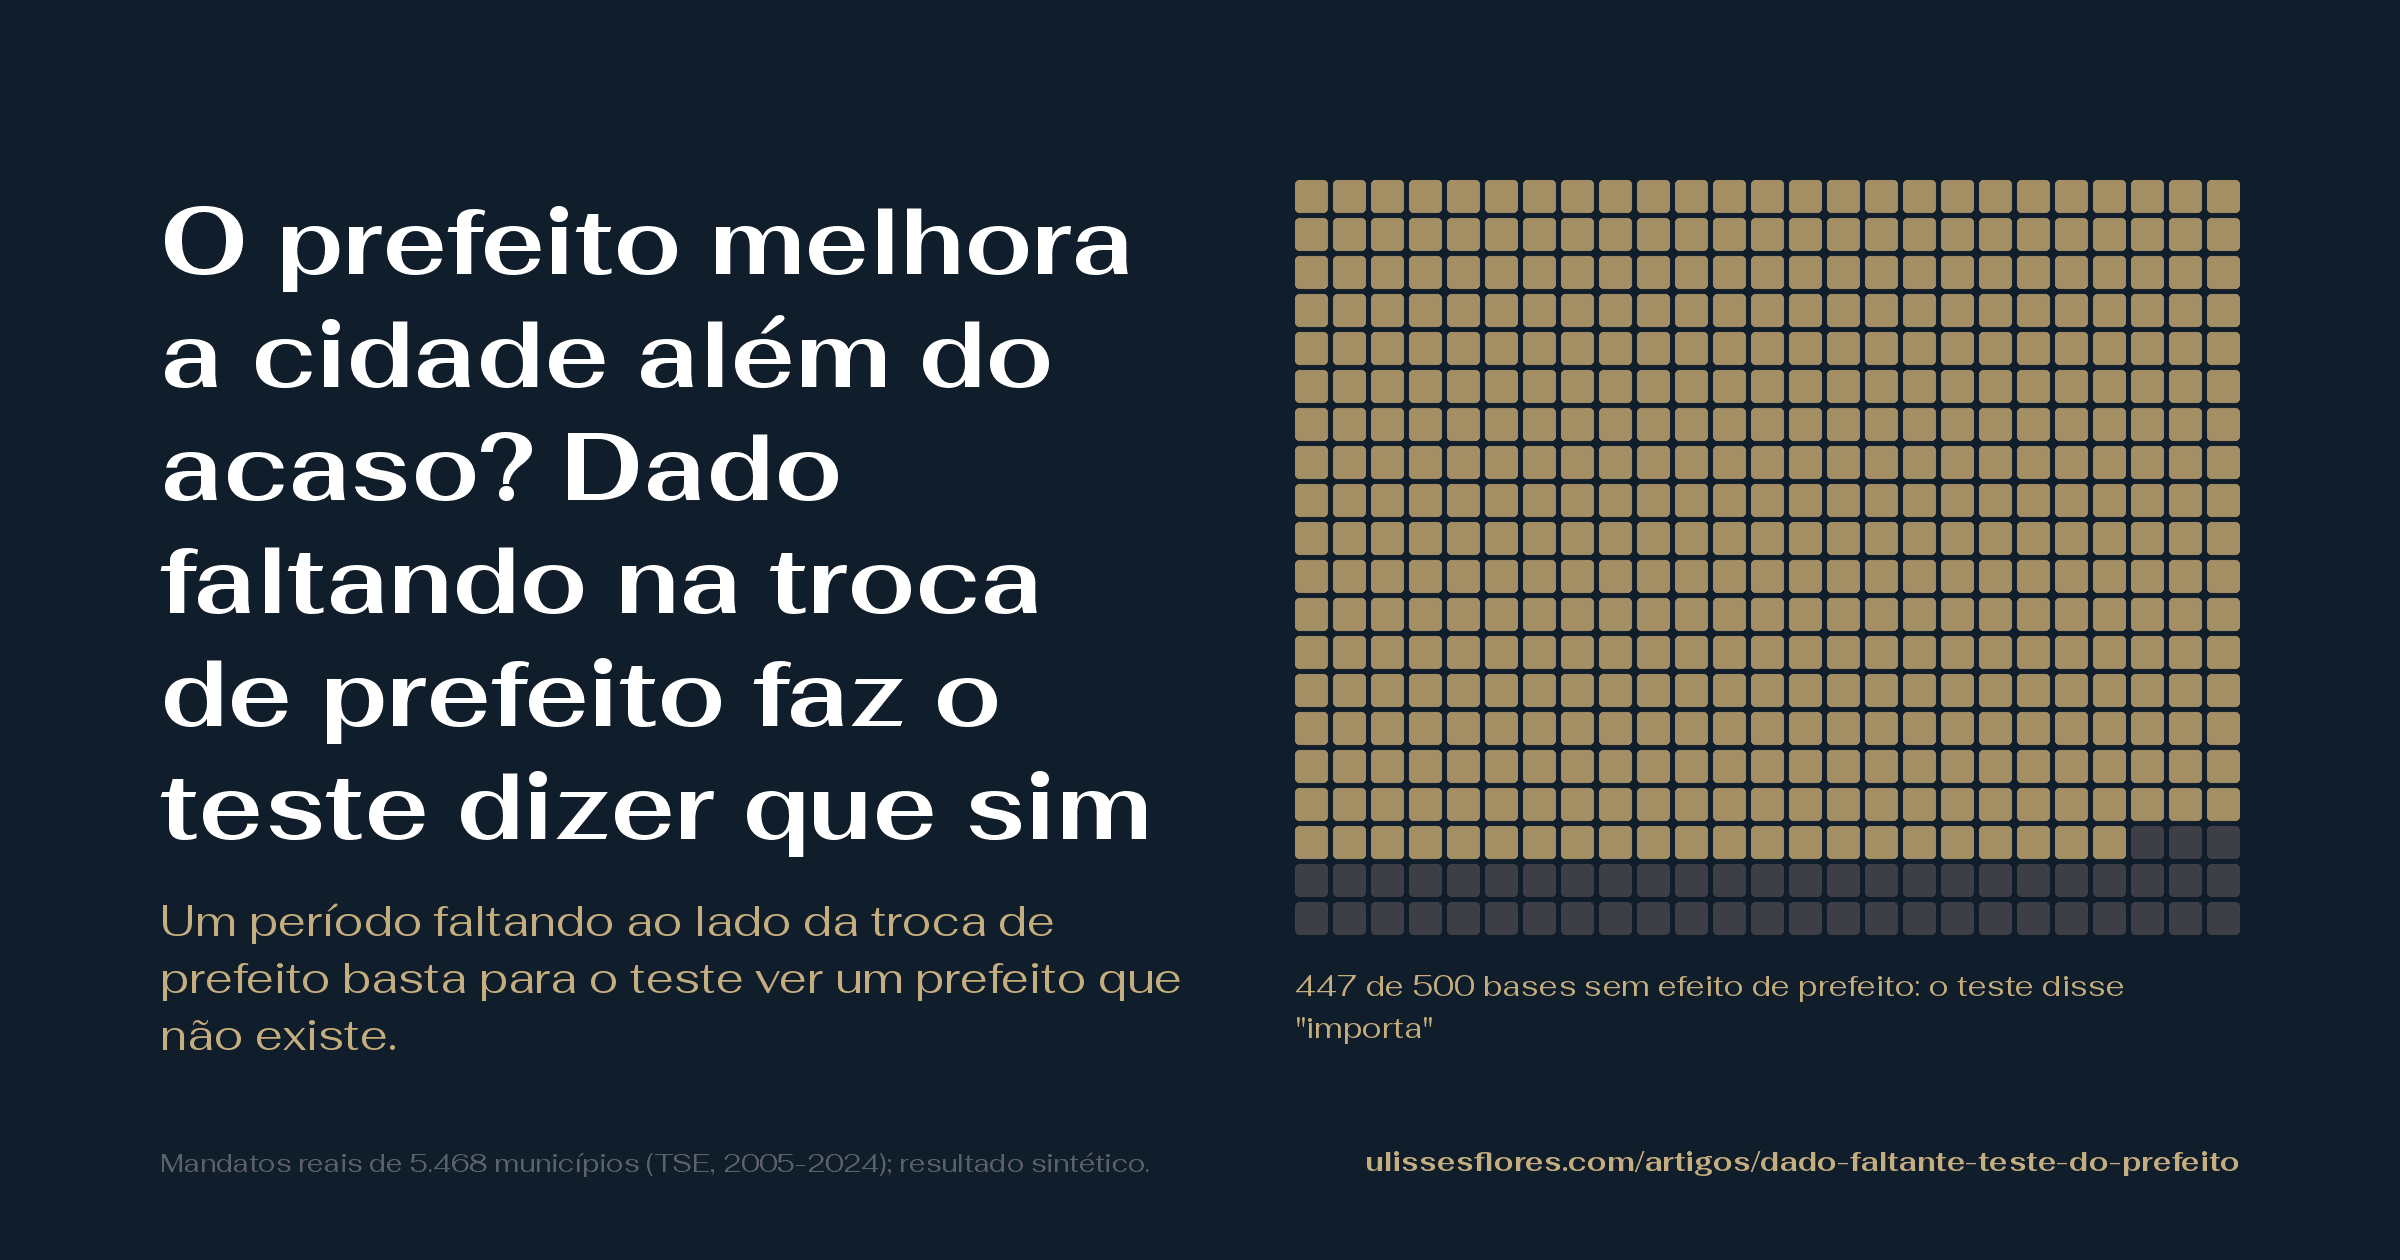
O teste que eu usei para saber se o prefeito brasileiro melhora a cidade disse que sim em cidades onde nenhum prefeito fazia diferença. O teste foi publicado na Science Advances em 2021, por Christopher Berry e Anthony Fowler. Eu o apliquei a um índice de nota escolar, receita própria e mortalidade infantil, de 2005 a 2024. Antes de olhar os prefeitos reais, rodei o teste em dados inventados, sem prefeito nenhum fazendo diferença. Nas cidades com um buraco no meio da série, ele disse "importa" em 64,0% de 200 simulações. Um teste honesto diria isso em cerca de 5%. O estudo parou.
Com o buraco só no começo ou no fim da série, a mesma conta deu 5,0%. A borda cumpria o combinado; o miolo inventava prefeito. Não é a primeira vez que um estudo meu para no meio por causa do que aparece no caminho: aconteceu também em a recusa que parou o estudo das recusas.
Não reanalisei nenhum resultado publicado de Berry e Fowler e não digo que algum esteja errado. A correção, a opção nostitch ("sem costura"), já existe no pacote deles. O que eu medi é o que as simulações deles não juntam: um período faltando, anos vizinhos parecidos entre si e milhares de municípios.
Arrancar uma página do diário e colar as vizinhas não transforma dois dias distantes em dias seguidos
Colar a página de antes na de depois não devolve o dia que faltou. Só finge que os dois lados foram vizinhos.
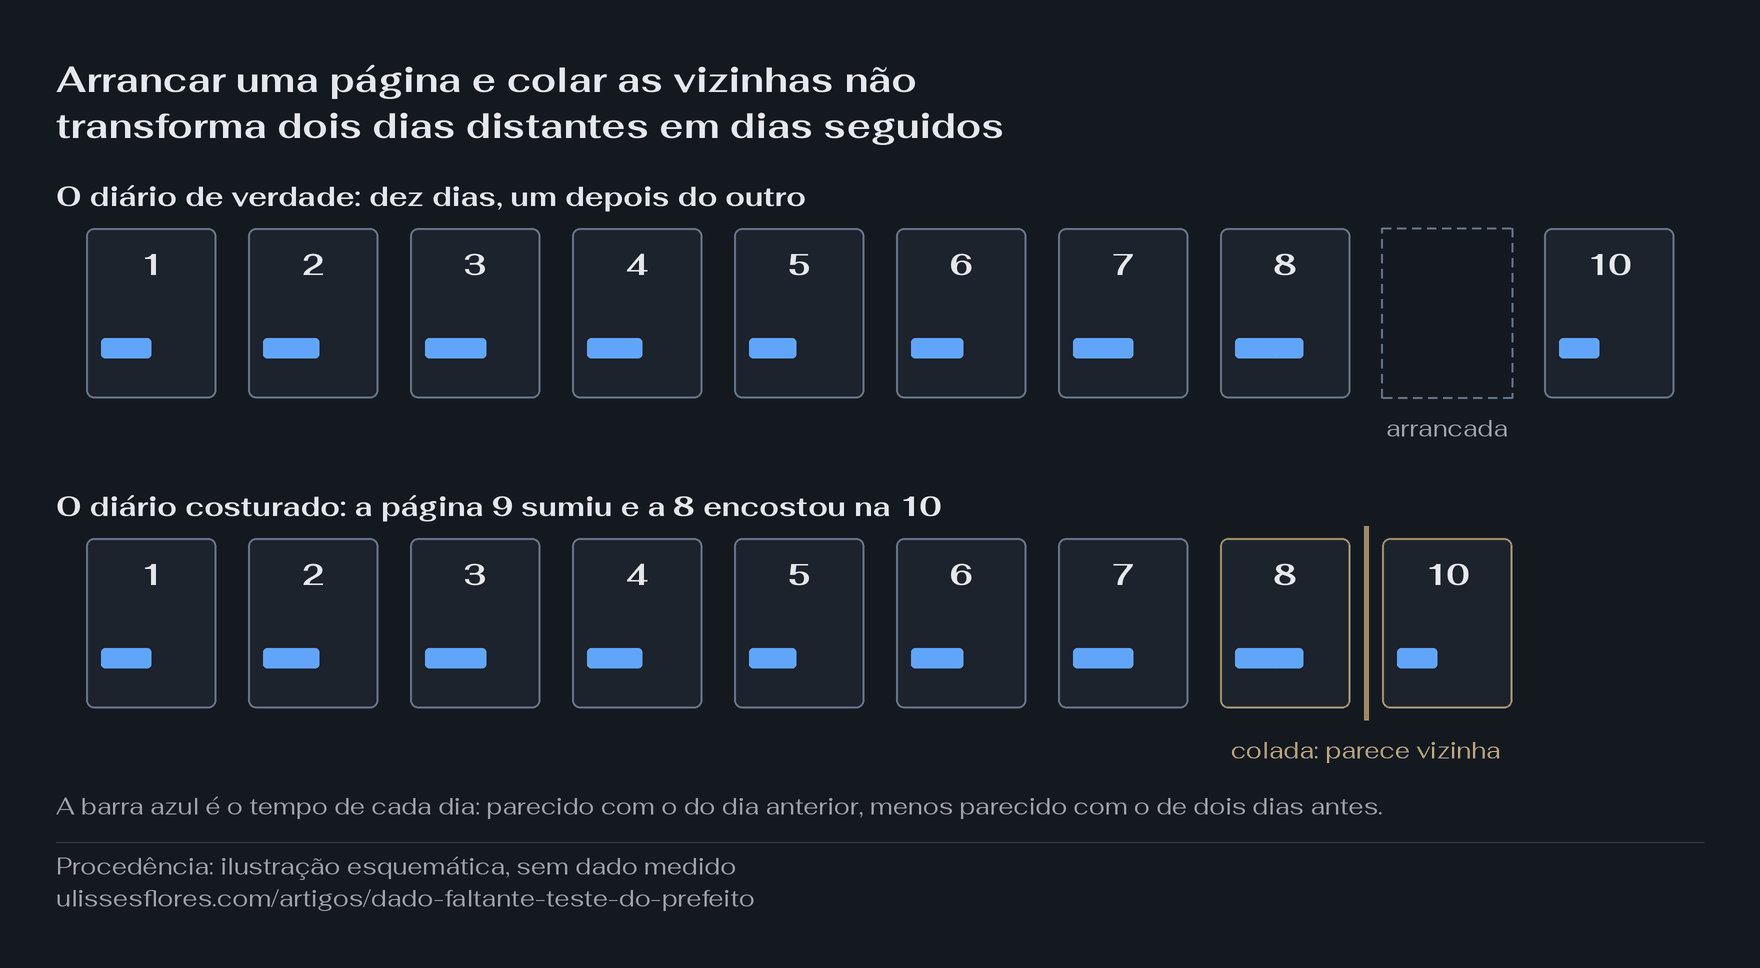
Repare nas páginas 8 e 10 de baixo. No caderno, ficaram lado a lado. No calendário, estão a dois dias de distância. O tempo de um dia se parece com o do dia anterior e um pouco menos com o de dois dias antes, e a cola esconde essa diferença.
Na cidade, cada página é um meio-mandato de dois anos, e o "tempo" é o índice da cidade. Nota escolar, receita e mortalidade infantil também se parecem de um biênio para o seguinte. Esse parentesco entre períodos vizinhos se chama correlação serial (serial correlation, "correlação ao longo do tempo"). Nas simulações, ele é modesto (coeficiente 0,217, calibrado no índice real) e enfraquece com a distância.
Berry e Fowler tratam os anos sem dado exatamente como a cola do diário. Nas palavras do artigo: "we drop those observations and stitch together blocks of time" ("descartamos essas observações e costuramos os blocos de tempo"). O pacote rifle, para o programa estatístico Stata (catálogo SSC, código S458461), faz a mesma costura por padrão.
O teste embaralha a ordem dos mandatos e pergunta se a ordem real explica mais
O teste não mede se a cidade melhorou. Mede se a ordem verdadeira dos prefeitos explica o índice melhor do que ordens sorteadas.
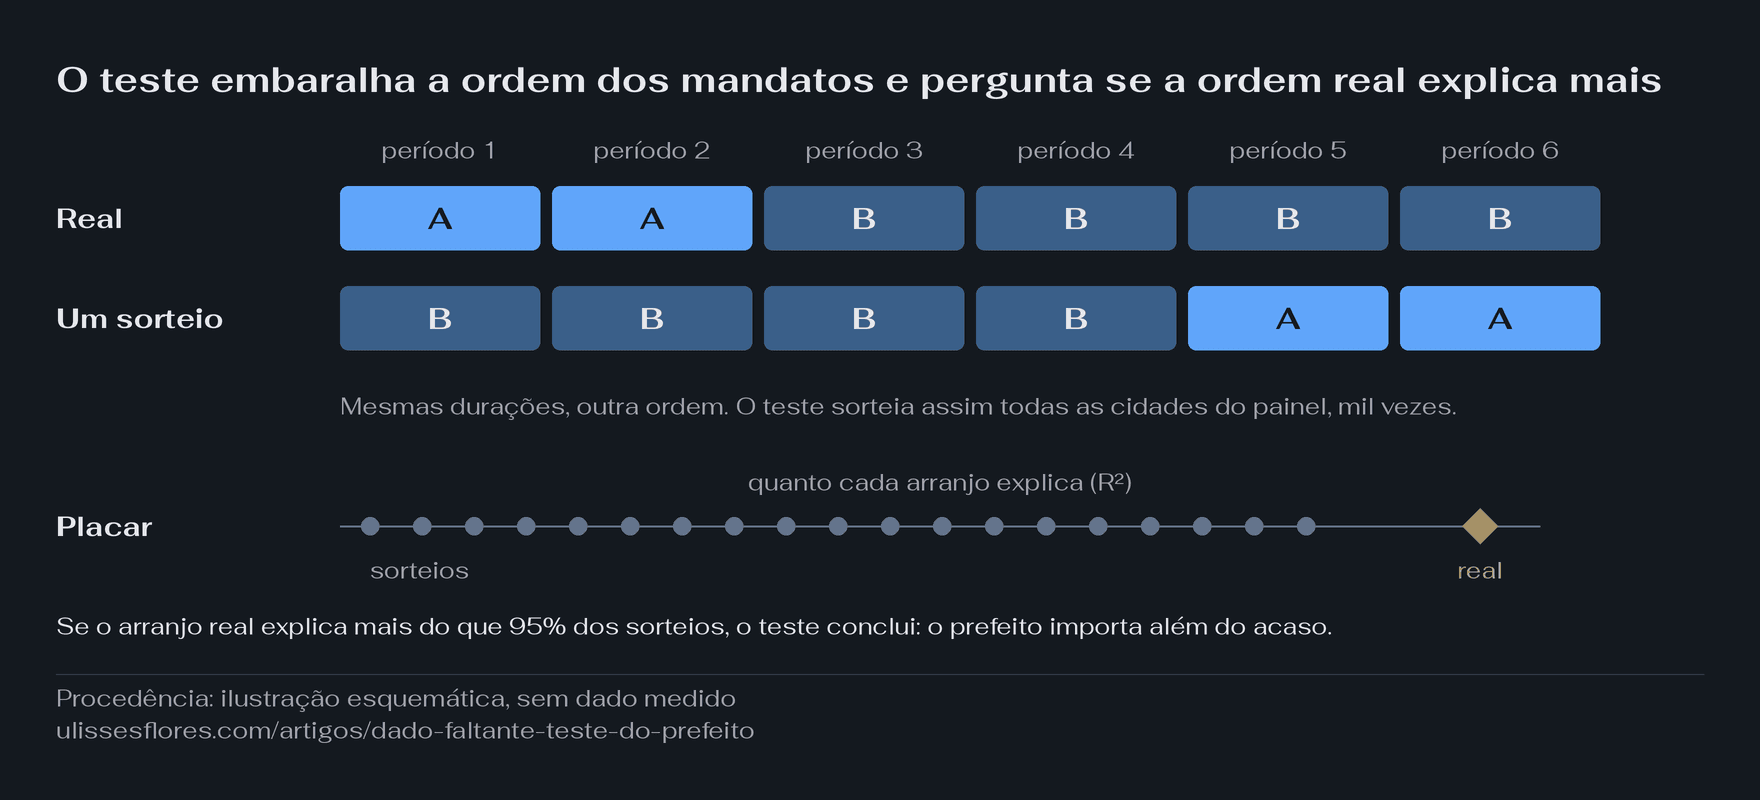
Repare que as duas faixas têm as mesmas pessoas e as mesmas durações; só a ordem muda. O nome do teste é RIFLE, de Randomization Inference for Leader Effects ("inferência por aleatorização para efeitos de líder").
A conta, sem fórmula: eu cubro o nome do prefeito e tento adivinhar o índice de cada período. Depois descubro o nome. Se os períodos de cada pessoa se parecem entre si, saber o nome ajuda a adivinhar. A fatia da variação que o nome explica, de zero a um, é o R² (R-squared, "R ao quadrado"). O teste calcula o R² da história real, com todas as cidades do painel juntas, e o compara com o R² de mil sorteios. Em cada sorteio, a ordem dos mandatos de cada cidade é embaralhada, o que se chama permutação (permutation, "reordenação"). Se a história real ganha de quase todos os sorteios, a conclusão é que o líder importa além do acaso.
Todo teste erra de vez em quando, e o combinado é errar pouco. Um detector de fumaça pode apitar por engano em 5% das noites; se apita em 89% das cozinhas sem fogo, está com defeito. Essa taxa de alarme falso, medida quando o prefeito não importa, se chama tamanho do teste (size of the test). Berry e Fowler mediram esse tamanho em simulações sem buraco no meio da série, como painéis de 20 unidades por 20 períodos, ou sem correlação serial. O defeito que parou meu estudo mora justamente na combinação das duas coisas.
Com o buraco na troca de prefeito, só o sorteio atravessa o buraco
Quando o buraco separa dois prefeitos, o mandato real para na porta dele. Só o sorteio costurado junta anos distantes no calendário.
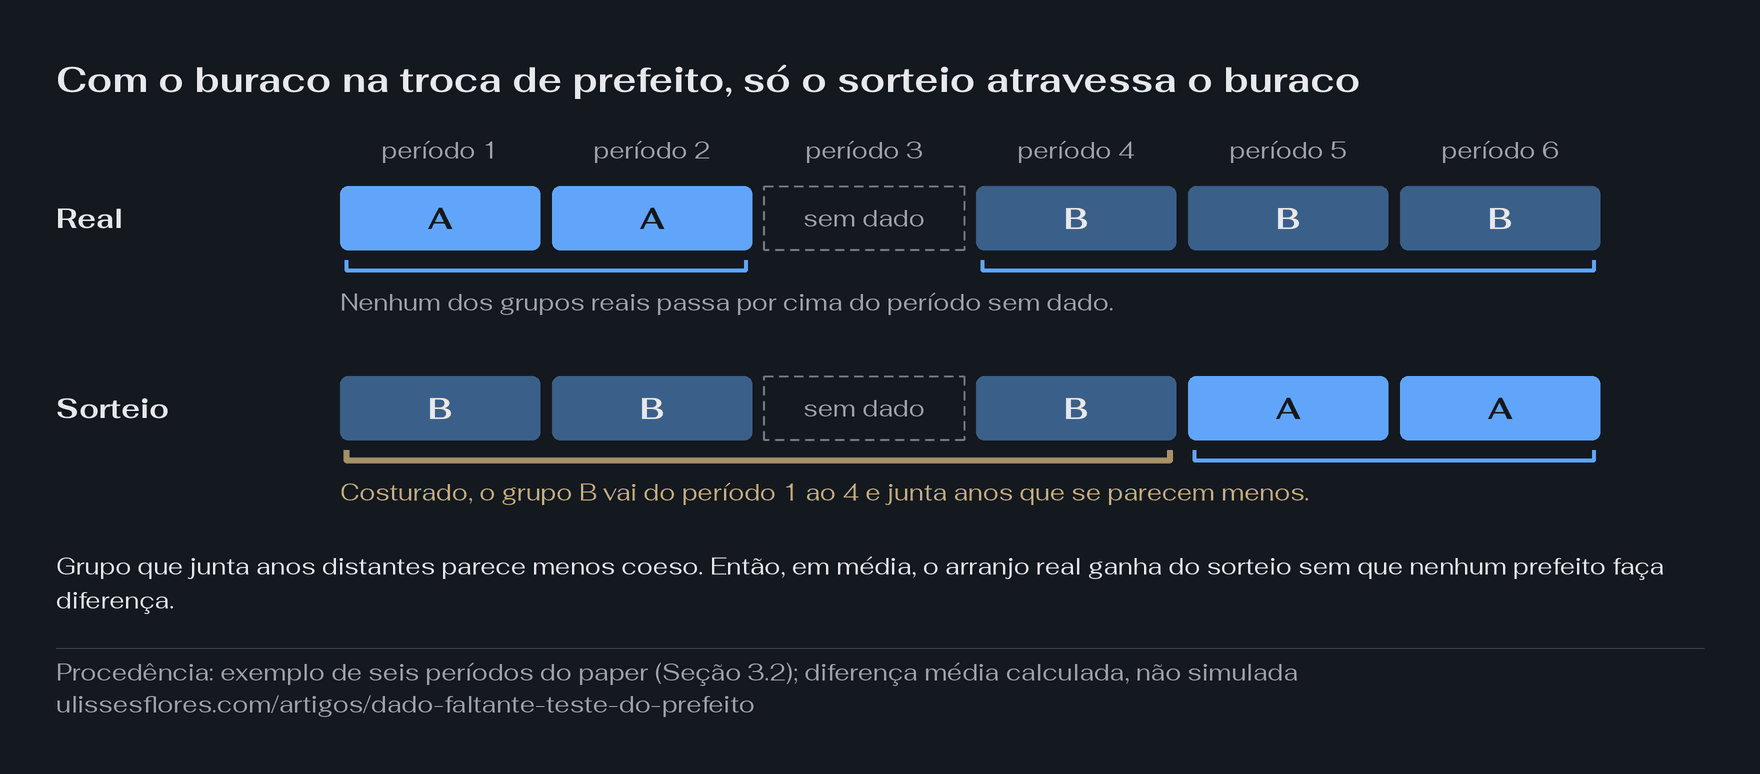
Repare no colchete dourado. O prefeito A governa os períodos 1 e 2, o B governa do 3 ao 6, e falta justamente o 3, o da troca. Na história real, nenhum mandato atravessa o buraco. No sorteio em que B vem primeiro, a costura põe o período 4 colado ao 2, e o grupo de B passa a juntar os períodos 1, 2 e 4.
Os períodos 4 e 5 se parecem, porque são vizinhos de verdade. Os períodos 2 e 4 se parecem menos, porque há um biênio inteiro entre eles. O arranjo real só junta vizinhos; o sorteado junta períodos distantes, e por isso parece menos coeso. Em média, o R² real fica maior que o do sorteio, mesmo com o índice gerado sem nenhum efeito de pessoa. O alarme toca por causa da cola, não do fogo.
Sem o parentesco entre anos vizinhos, a cola não engana. Numa simulação com coeficiente zero, buraco em 2021-22 e 1.000 municípios, o teste disse "importa" em 6,4% das bases, compatível com 5%.
O buraco em outro lugar muda o lado do erro
O sinal depende de onde o buraco cai. No meio de um mandato longo, o teste ficou cauteloso: 0,2% em 867 municípios.
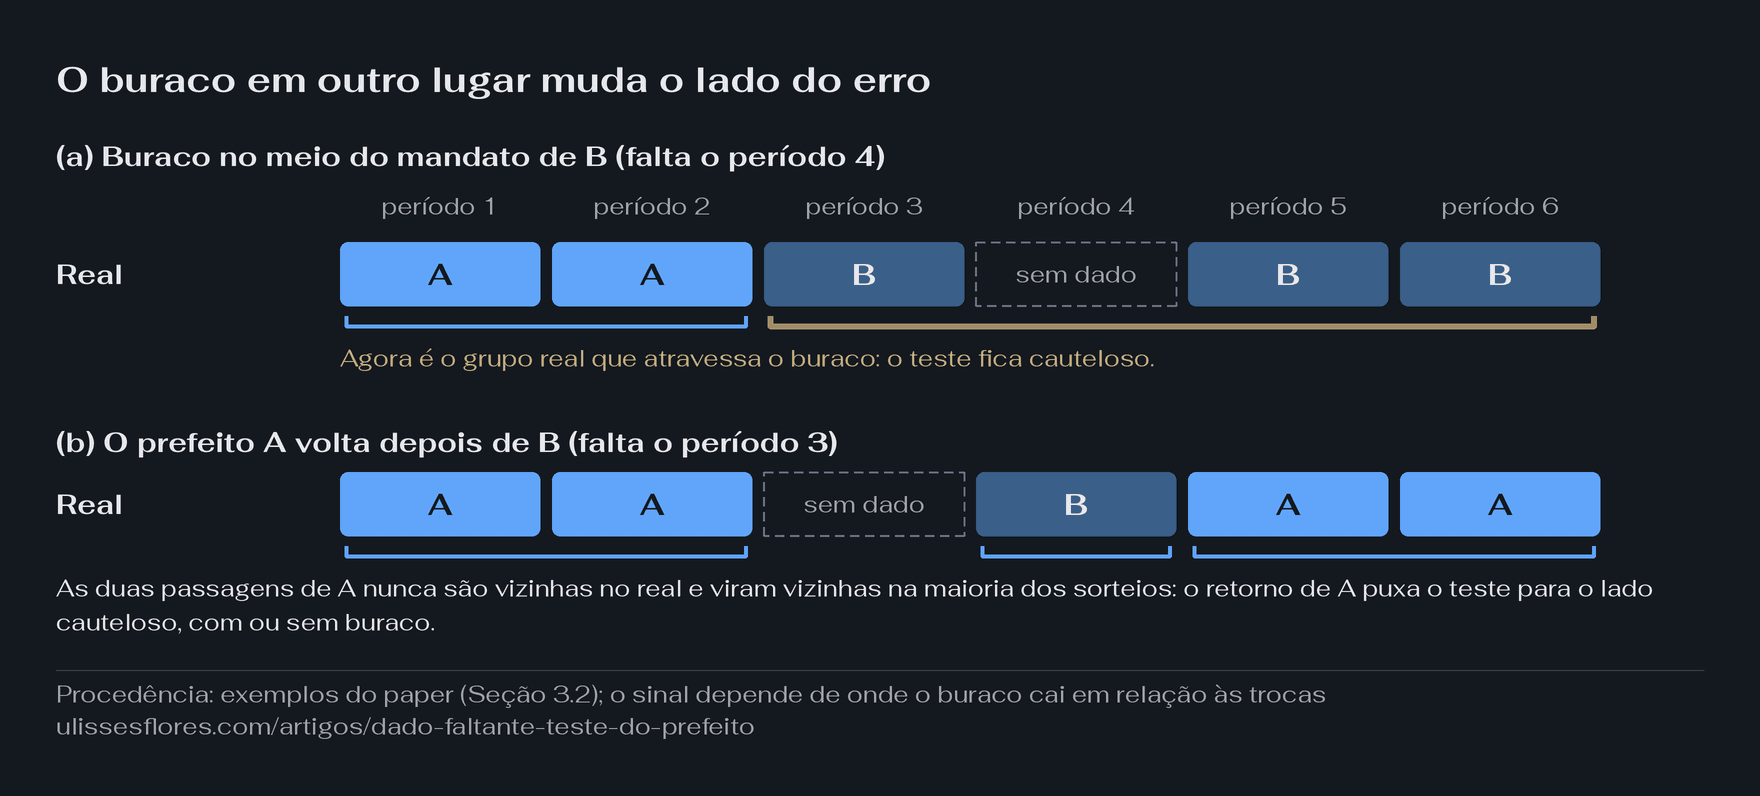
Repare que, na cena (a), o colchete dourado agora é o do arranjo real. Com o buraco no meio do mandato de B, é a história verdadeira que junta anos distantes, e o sorteio é que fica com vizinhos. O teste passa a errar para o lado cauteloso: nos 867 municípios com o buraco no meio de um mandato longo, ele disse "importa" em 0,2% das bases, bem abaixo dos 5%.
Na cena (b), o prefeito A sai e volta depois de B. O pacote agrupa os mandatos pela pessoa, e as duas passagens de A formam um grupo só, que nos dados reais nunca fica colado. Nos sorteios, elas viram vizinhas na maioria das ordens. Quem puxa o teste para o lado cauteloso aqui é o retorno de A, e isso acontece mesmo sem buraco nenhum; o buraco na troca só diminui esse empurrão, sem invertê-lo. São médias da conta exata do paper, não taxas de alarme simuladas.
O paper traz ainda um exemplo com o buraco dentro de um mandato em que o arranjo real volta a ser favorecido. A regra que sobra é simples de dizer e chata de aplicar: o lado do erro depende de onde o buraco cai em relação às trocas de prefeito, e não só do tamanho do buraco.
Poucas cidades escondem o defeito, e o painel inteiro o transforma em quase certeza
Com 50 municípios, o alarme falso fica em 6,8%, ainda compatível com 5%. Com 5.468, chega a 89,4%.
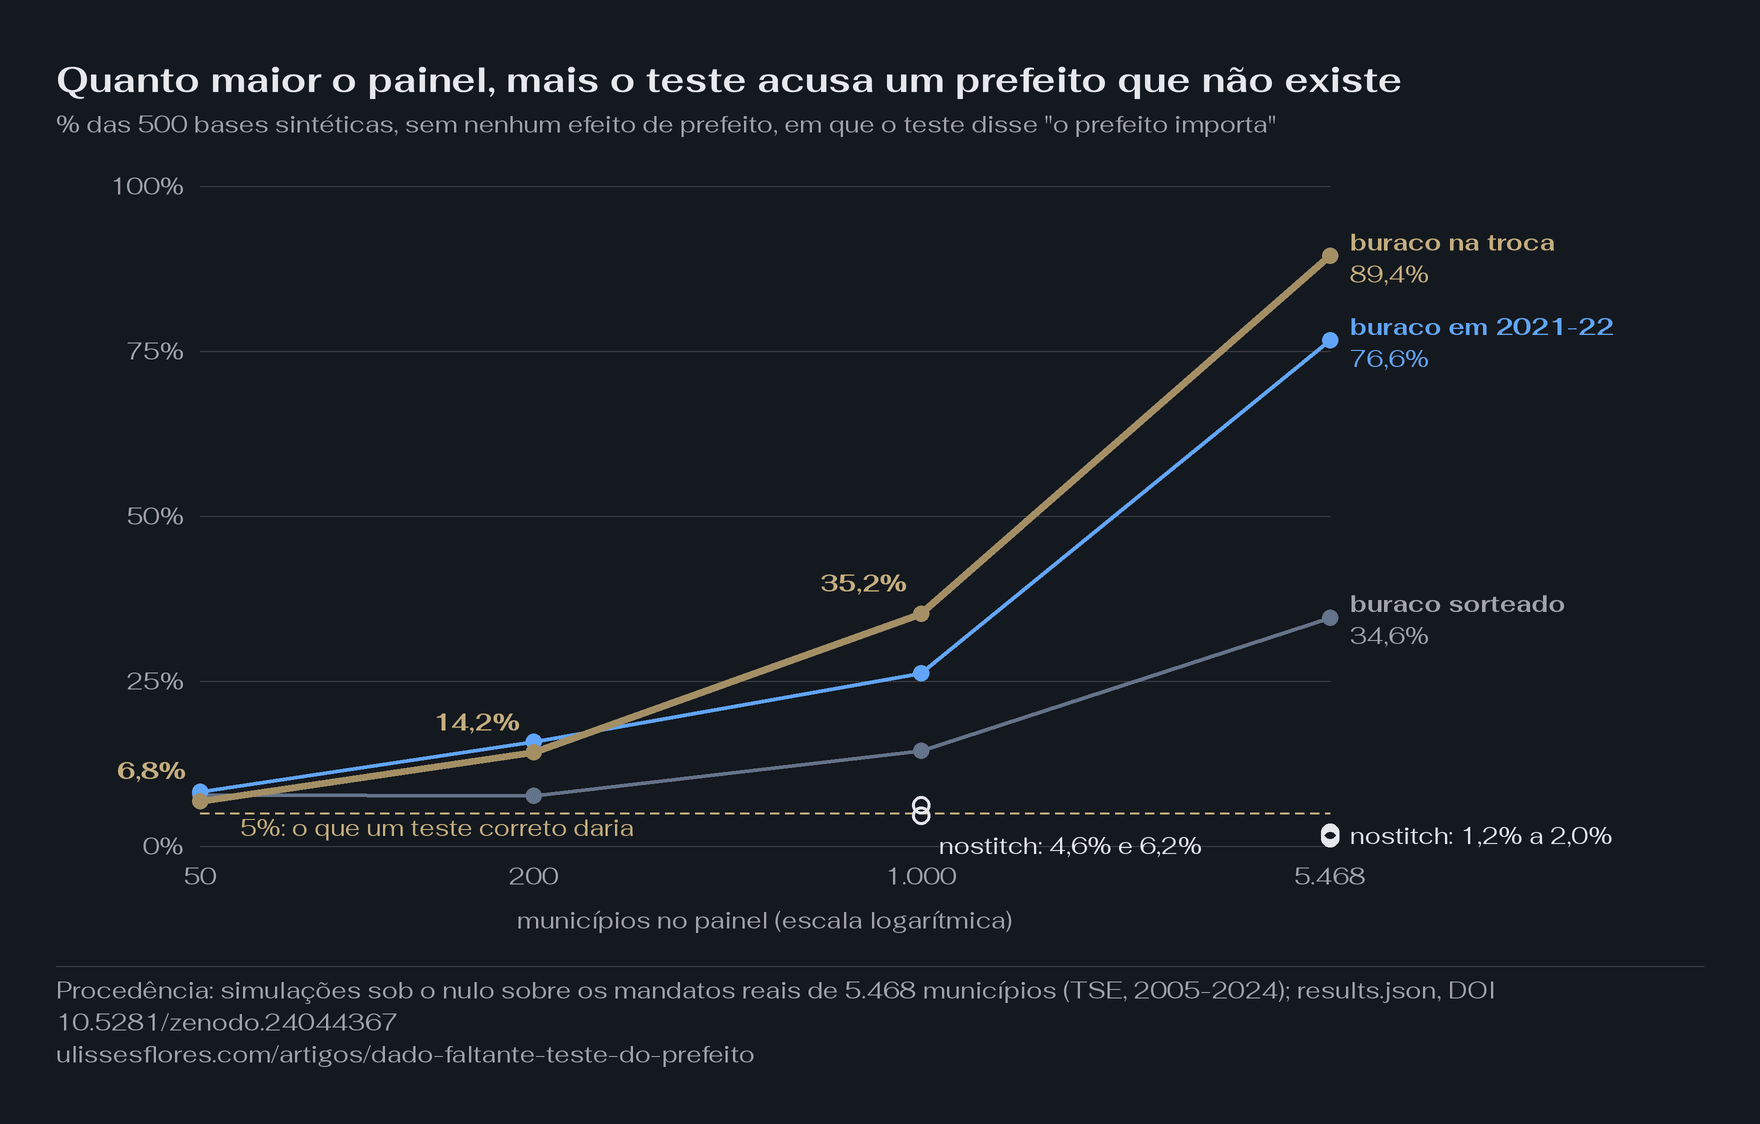
Repare no começo e no fim da linha dourada. Com 50 municípios e o buraco na troca, o erro mal se distingue dos 5% que todo teste tem direito de errar, e é por isso que ele passa despercebido em painéis pequenos. Com o Brasil municipal inteiro, o teste diz que o prefeito importa em quase nove de cada dez bases em que nenhum prefeito importa.
| Municípios | Buraco na troca | Buraco em 2021-22 | Buraco sorteado | Com nostitch |
|---|---|---|---|---|
| 50 | 6,8% | 8,2% | 7,8% | não medido |
| 200 | 14,2% | 15,8% | 7,6% | não medido |
| 1.000 | 35,2% | 26,2% | 14,4% | 4,6% (2021-22), 6,2% (sorteado) |
| 5.468 | 89,4% | 76,6% | 34,6% | 1,2% (troca), 1,6% (2021-22), 2,0% (sorteado) |
As três colunas da costura são três lugares para o buraco. "Na troca" é o caso puro: o buraco sempre separa prefeitos diferentes. "2021-22" é o meio-mandato logo depois da eleição, que em 62,3% dos municípios separa prefeitos diferentes e, nos demais, tem a mesma pessoa dos dois lados; por isso, nos painéis grandes, fica abaixo do caso puro. "Sorteado" é um período do meio da série, escolhido ao acaso: mesmo assim, 70,1% desses buracos caem ao lado de uma troca, porque os mandatos são curtos, e o painel inteiro chega a 34,6%.
Com o padrão real de dados faltantes do índice do meu estudo, o resultado é o mesmo. Usei só a informação de quais municípios têm o índice em cada período e inventei o resto. Nos 1.854 municípios com buraco no meio da série, a costura disse "importa" em 34,8% das bases, e o nostitch em 3,6%. Nos 707 com buraco só na borda, a costura deu 3,8%. Os 64,0% que pararam o estudo vieram do motor do próprio estudo; o pacote oficial, nos mesmos buracos, dá esses 34,8%. Os dois estão longe de 5%.
Com nostitch, a inflação de dezenas de pontos some nas células medidas: com 1.000 municípios o teste fica perto de 5% (4,6% e 6,2%), e no painel inteiro fica até cauteloso. Sem buraco nenhum, o pacote já fica abaixo de 5% (2,2% com 1.000 municípios e 0,2% com os 5.468), e a causa disso não foi isolada. Quando o prefeito importa de verdade (efeito igual a 10% da variação), o teste detecta em 98,8% das bases sem buraco e em 98,4% com nostitch, ambos com 1.000 municípios. A correção, ali, não cega o teste. Essa detecção só foi medida em células em que o nostitch não descarta nenhum trecho; com o buraco na troca, com 50 e 200 municípios e no painel inteiro, não medi.
Com milhares de diários, o mesmo buraco vira erro quase certo
Um diário com uma página colada engana pouco. Milhares, colados no mesmo lugar, enganam quase sempre, porque o teste soma todos.
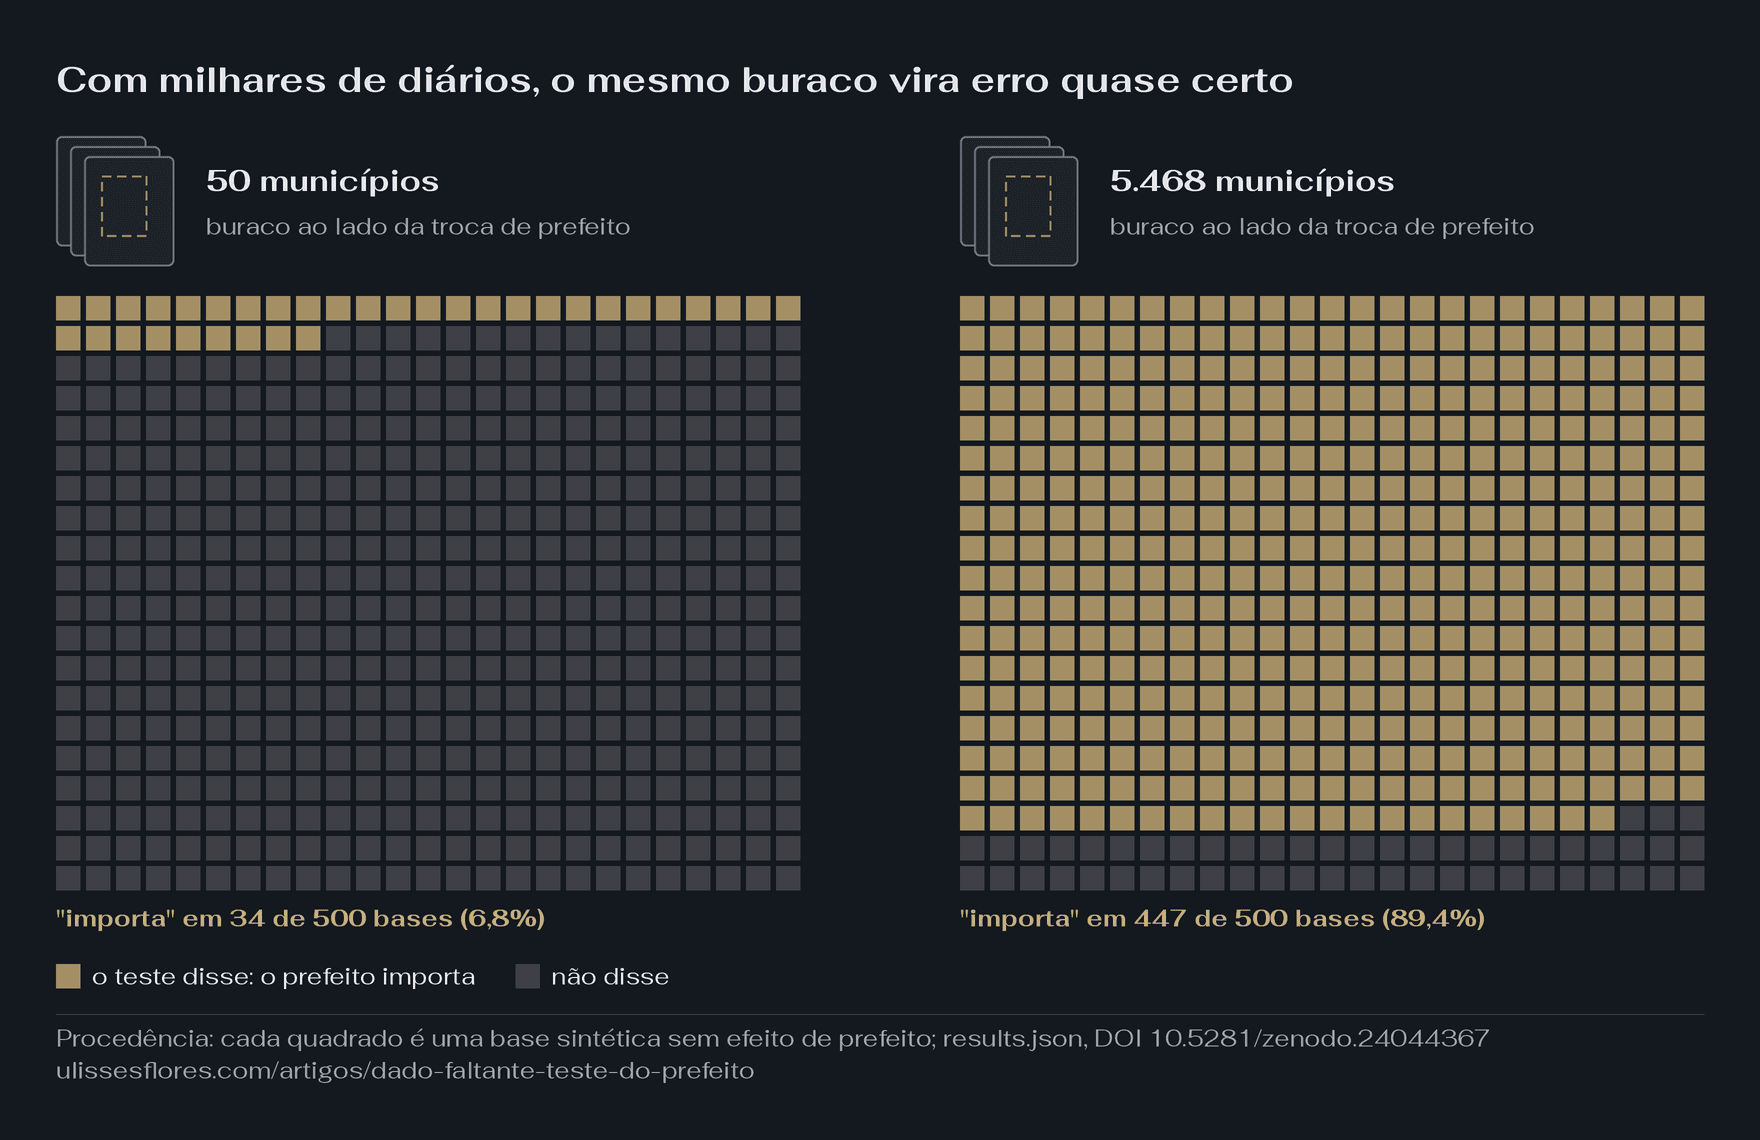
Repare que a pilha de diários é a da primeira figura, agora com a página arrancada sempre no mesmo lugar em relação à troca de prefeito. Cada município empurra o resultado um pouquinho para o mesmo lado. Com 50, o empurrão some no meio da variação normal do teste; com 5.468, os empurrões se somam e o teste quase sempre conclui que o prefeito importa. Os painéis pequenos e sem buraco em que o tamanho do teste foi conferido não tinham esta pilha.
Foi o que aconteceu no meu estudo. Refiz o teste sorteando a ordem só dentro de trechos contínuos, parente do nostitch, e confirmei o tamanho em 5,2% numa rodada de 2.000 bases declarada antes. Só então olhei os prefeitos reais, uma única vez. Não apareceu evidência de efeito do prefeito: o valor-p na amostra principal foi 0,869, ou seja, a maioria dos sorteios explicou o índice melhor do que a história real. A conclusão registrada é "equivalência não demonstrada". Os dados não mostram efeito do prefeito, e também não permitem dizer que o prefeito não importa.
Saber se um governante importa é uma pergunta diferente de saber se uma política funcionou. A segunda tem os seus próprios métodos, e o que eles já mediram no Brasil está em o que a pesquisa científica mediu de forma causal sobre as políticas do Brasil. E quando a pergunta é "qual governo foi melhor", os dados públicos respondem só uma parte, como mostrei em o que os dados públicos respondem sobre o melhor governo do Brasil.
O que eu faria com isso
Eu não escreveria que um líder importa sem antes medir o alarme falso do teste em dados em que nenhum líder importa.
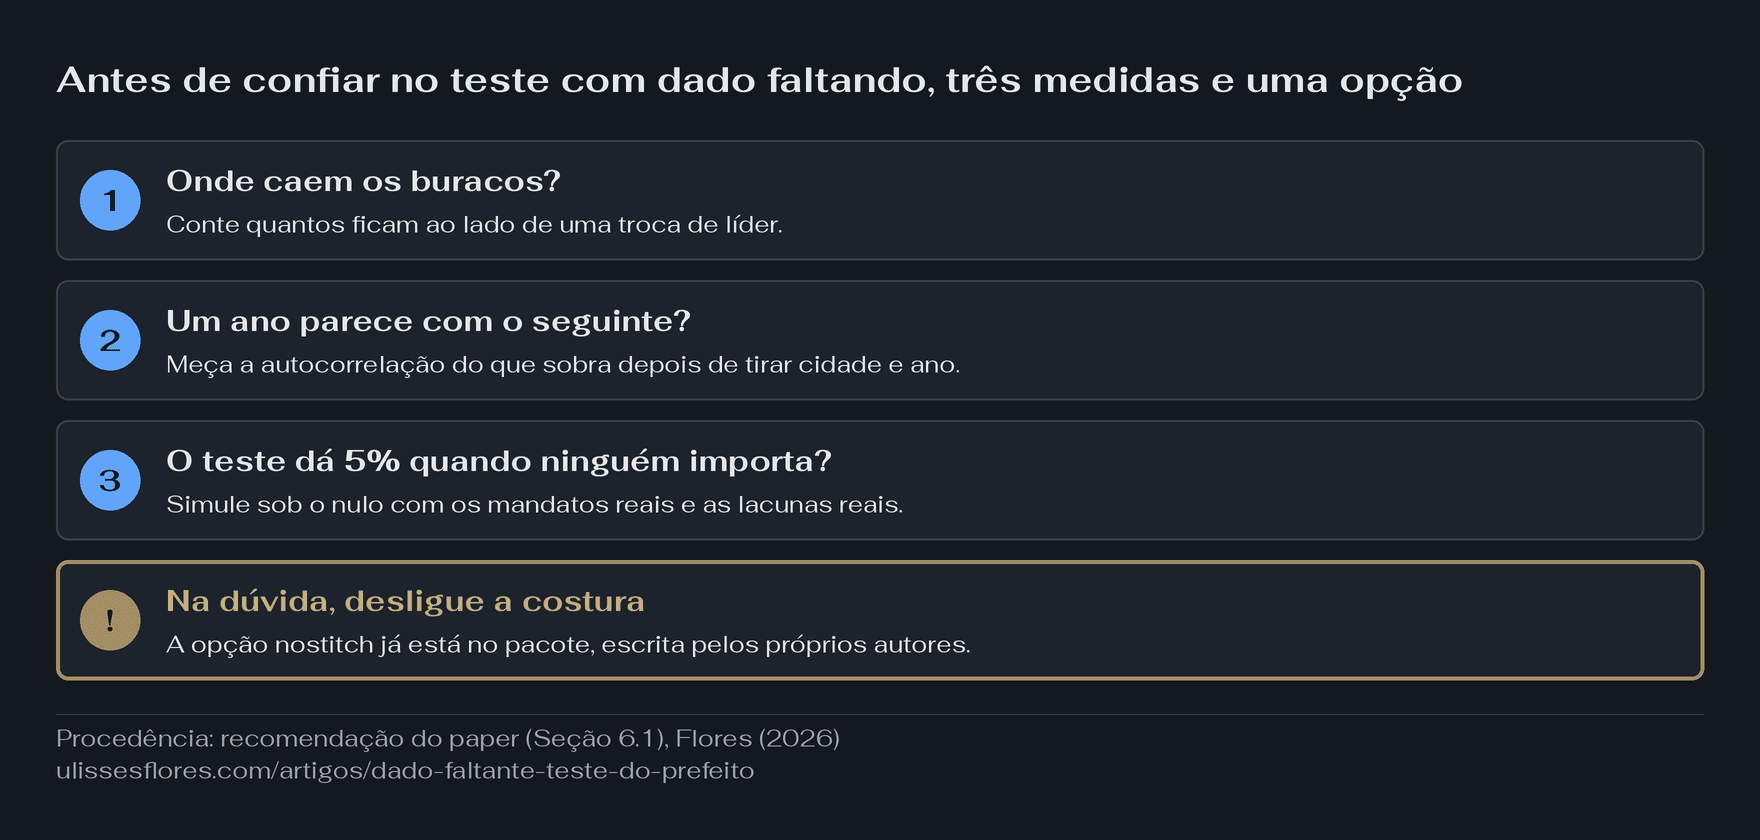
- Onde caem os buracos? Conte quantos ficam ao lado de uma troca de líder. Aqui, 70,1% dos buracos sorteados caem nesse lugar.
- Um ano parece com o seguinte? Meça a autocorrelação do resíduo, o que sobra do resultado depois de descontar a cidade e o ano. Com 1.000 municípios e o buraco em 2021-22, a costura deu 6,4% com coeficiente zero e 26,2% com 0,217.
- O teste dá 5% quando ninguém importa? Simule o teste em dados sem efeito de líder, com os mandatos reais e os buracos reais. Calibrar num painel pequeno e publicar num grande é calibrar outra pergunta.
- Na dúvida, desligue a costura. A ajuda do pacote já recomenda o
nostitch"if there is a long gap between periods or some other reason not to comprate [sic] observations across missing periods" ("se há uma lacuna longa entre períodos ou outra razão para não comparar observações através dos períodos faltantes"). O que estas simulações acrescentam é que um buraco curto, de um único meio-mandato, já basta quando cai na troca: o comprimento sozinho não basta para o diagnóstico, e a posição do buraco em relação às trocas precisa entrar nele.
O nostitch não é garantia universal. No painel inteiro ele deixou o teste cauteloso, entre 1,2% e 2,0%; com 1.000 municípios ficou perto de 5% (4,6% e 6,2%, este último sem excluir alguns pontos de inflação); em painéis com outra estrutura, não foi medido. E vale repetir: não reanalisei nenhum resultado publicado de Berry e Fowler, e a correção é deles.
Quando o artigo saiu, em 2021, a conversa aberta no X e no Reddit foi sobre quem importa mais, se o presidente de empresa ou o técnico do time. Numa busca em 7 de novembro de 2026, não achei nenhum post sobre dado faltante. Nas bases acadêmicas que consultei (OpenAlex, Semantic Scholar, Crossref, a primeira página do Google Scholar, além da ajuda e do código do pacote), também não achei a distorção documentada. Um trabalho que estende o RIFLE, de Smith e Gray (2021), não li na íntegra; se ele tratou de buracos, a parte do "ninguém tinha documentado" cai, e a medida feita aqui continua.
Dados e código. O código, a tradução do pacote para Python, as saídas das simulações e o paper completo em quatro línguas estão no repositório público rifle-gap-bias, versão 1.0.0, citável pelo DOI de conceito 10.5281/zenodo.24044367. Na pasta do repositório, python run_all.py refaz as figuras e a tabela e confere cada número do paper. Se a sua conta der diferente da tabela acima, me mande: eu corrijo e dou o crédito.
Nota metodológica. Números conferidos em 7 de novembro de 2026 contra o
results.jsondo repositório, versão 1.0.0. Mandatos reais do Tribunal Superior Eleitoral: 5.468 municípios, dez meios-mandatos de dois anos, 2005-2024. Resultado sintético: ruído autorregressivo com coeficiente 0,217, calibrado no índice real, sem nenhum efeito de prefeito nas simulações de alarme falso. Cada célula tem 500 bases e 1.000 sorteios por base. Os 64,0% do piloto vêm do motor do estudo, não da tradução do pacote. A tradução do pacote para Python foi testada à mão, não contra o Stata, que eu não tinha.
Fontes
- Berry, C. R., & Fowler, A. (2021). Leadership or luck? Randomization inference for leader effects in politics, business, and sports. Science Advances, 7(4), eabe3404. https://doi.org/10.1126/sciadv.abe3404
- Berry, C. R., & Fowler, A. (2018). RIFLE: Stata module to perform randomization inference for leader effects. Statistical Software Components S458461. https://ideas.repec.org/c/boc/bocode/s458461.html
- Flores, C. U. (2026). Does a mayor improve a city beyond chance? Missing data at a change of mayor makes the test say yes: Replication package (versão 1.0.0). Zenodo. https://doi.org/10.5281/zenodo.24044367. Repositório: https://github.com/ulissesflores/rifle-gap-bias
- Smith, D. S., & Gray, T. R. (2021). Looking for leadership in historical context: An extension of the RIFLE method of randomization inference. Journal of Historical Political Economy, 1(2), 215-234. https://doi.org/10.1561/115.00000010 (não lido na íntegra)
- Tribunal Superior Eleitoral. Portal de dados abertos. https://dadosabertos.tse.jus.br
Verificado em 2026-11-07 contra o results.json e o paper do repositório rifle-gap-bias, versão 1.0.0. Não rodei o Stata: a tradução do pacote para Python foi testada à mão. Não reanalisei nenhum resultado publicado de Berry e Fowler. Não li Smith e Gray (2021) na íntegra. A busca no X e no Reddit foi feita por outro agente, e eu não abri cada post. Os resultados das simulações são sintéticos: a estrutura dos mandatos é real, o índice foi inventado de propósito, sem efeito de prefeito.